Индия представила три отечественные базовые модели ИИ для укрепления технологического суверенитета
Министерство электроники и информационных технологий Индии запустило модели Eka-1, Dhir 2B и Dhir 5B, разработанные местными стартапами Soket Labs и ZenteiQ для расширения национальной экосистемы искусственного интеллекта.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Индия представила три отечественные базовые модели ИИ для укрепления технологического суверенитета
Министерство электроники и информационных технологий Индии запустило модели Eka-1, Dhir 2B и Dhir 5B, разработанные местными стартапами Soket Labs и ZenteiQ для расширения национальной экосистемы искусственного интеллекта.
Эта статья переведена автоматически нашим редакционным ИИ с английского оригинала. Читать на английском
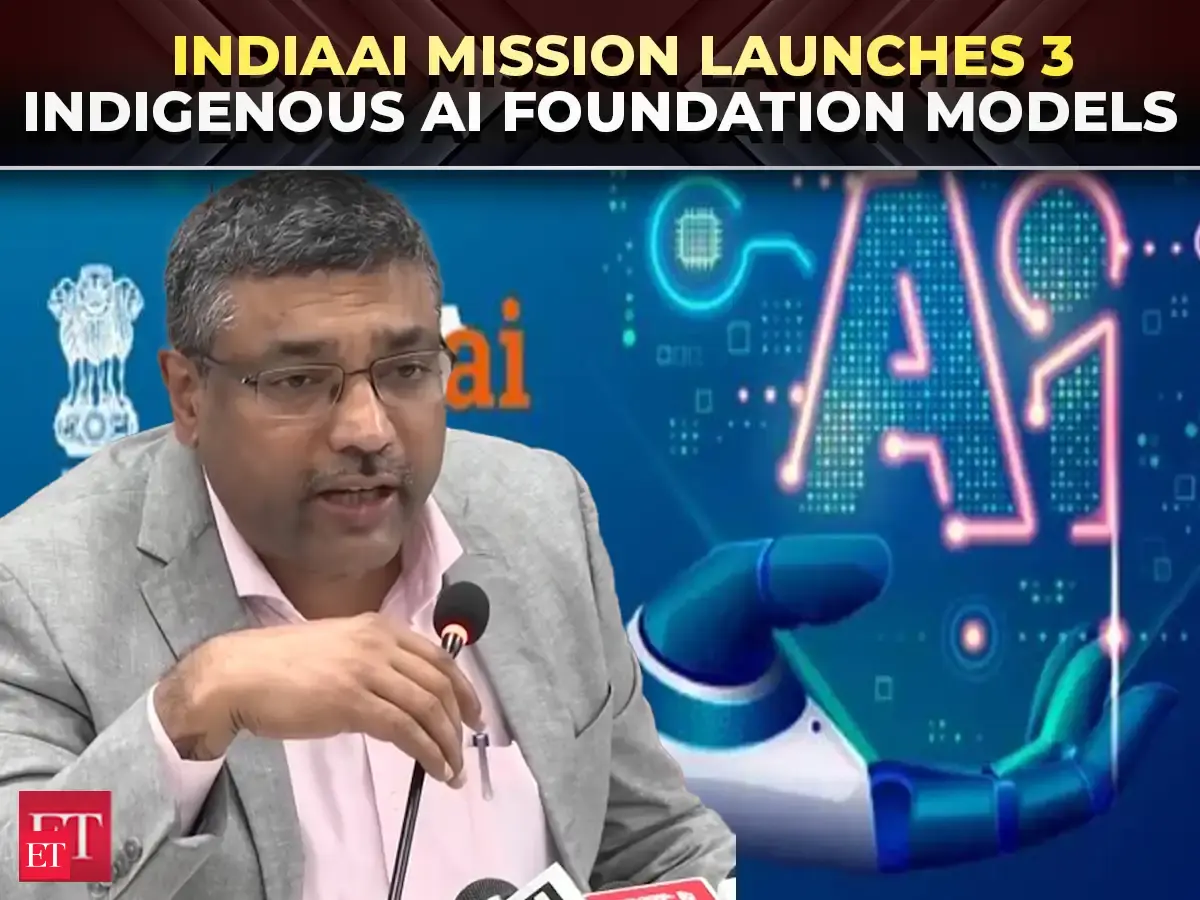
НЬЮ-ДЕЛИ — Министерство электроники и информационных технологий Индии в четверг провело официальную презентацию трех отечественных базовых моделей искусственного интеллекта, что ознаменовало государственный курс на создание суверенного потенциала в сфере ключевых архитектур машинного обучения. В число представленных систем вошли модель Eka-1, созданная Soket Labs, а также Dhir 2B и Dhir 5B, разработанные ZenteiQ. Публичный релиз моделей, состоявшийся в ходе официального мероприятия министерства с участием высокопоставленных государственных лиц и представителей отрасли, отражает усиливающиеся попытки Нью-Дели снизить стратегическую зависимость от импортных западных и китайских вычислительных платформ, адаптируя базовое программное обеспечение к многоязычным и институциональным требованиям Индии.
## Ключевые факты
- Министерство электроники и информационных технологий курировало запуск трех отечественных базовых моделей: Eka-1, Dhir 2B и Dhir 5B. - Модель Eka-1 была разработана индийским ИИ-стартапом Soket Labs. - Модели Dhir 2B и Dhir 5B, конфигурации которых насчитывают два миллиарда и пять миллиардов параметров соответственно, созданы местной компанией ZenteiQ. - Секретарь Министерства электроники и информационных технологий S. Krishnan руководил презентацией, назвав публичный запуск важнейшим ориентиром для национальной технологической повестки страны. - Инициатива согласуется с более широкой программой суверенного искусственного интеллекта Индии, включающей государственное субсидирование вычислительных мощностей и национальное управление данными.
## Что произошло
В ходе специальной презентации, организованной Министерством электроники и информационных технологий, представители правительства и технические специалисты собрались, чтобы представить три генеративные базовые архитектуры, полностью созданные индийскими инженерными командами. Секретарь министерства S. Krishnan возглавил церемонию, официально представив модель Eka-1 от Soket Labs, а также семейство моделей Dhir 2B и Dhir 5B от ZenteiQ. Krishnan подчеркнул, что открытие публичного доступа к базовым весам и архитектурам послужит структурной основой для независимой разработки программного обеспечения на субконтиненте.
Сами модели занимают различные сегменты в более широком ландшафте машинного обучения. Soket Labs разработала Eka-1 для решения фундаментальных задач, в то время как серия Dhir от ZenteiQ ориентирована на вычислительные среды с меньшим числом параметров. Числовые обозначения Dhir 2B и Dhir 5B указывают на масштабы параметров примерно в два миллиарда и пять миллиардов переменных — этот класс намеренно оптимизирован для периферийных вычислений, систем с низкой задержкой и сред инференса с ограниченным бюджетом, в отличие от массивных кластеров на сотни миллиардов параметров, поддерживаемых американскими технологическими гиперскейлерами.
В ходе презентации представители министерства подчеркнули, как публичный дебют этих систем сокращает разрыв между академическими исследованиями и коммерческим внедрением. Вместо того чтобы полностью полагаться на надстройки прикладного уровня, созданные поверх внешних интерфейсов прикладного программирования (API), министерство отметило стратегическую необходимость развития собственных архитектур, в которых обучающие корпуса, механики токенизации и протоколы согласования остаются под национальным контролем.
## Почему это важно
Появление отечественных базовых моделей имеет далеко идущие последствия для цифровизации предприятий, суверенитета данных и распределения национального технологического капитала. На протяжении десятилетий развивающиеся экономики выступали преимущественно потребителями зарубежных программных архитектур. В сфере искусственного интеллекта полная зависимость от проприетарных систем, поддерживаемых за пределами государственных границ, создает системные уязвимости, касающиеся доступа к платформам, регулярных лицензионных расходов, оттока валюты и внезапных изменений в работе сервисов, обусловленных зарубежными регуляторными юрисдикциями.
Благодаря созданию функциональных базовых моделей от Soket Labs и ZenteiQ местные разработчики получают доступ к инструментам, которые можно адаптировать под конкретные внутренние сценарии использования без передачи конфиденциальной информации через зарубежные центры обработки данных. Модели с меньшим объемом параметров, такие как Dhir 2B и Dhir 5B, особенно актуальны для децентрализованных корпоративных сред, таких как региональные банковские учреждения, муниципальные органы управления и местные медицинские клиники. Эти организации зачастую функционируют в условиях жестких бюджетных ограничений и фрагментированных телекоммуникационных сетей, что делает развертывание массивных моделей экономически нецелесообразным и технически неосуществимым.
Кроме того, лингвистический ландшафт Индийского субконтинента сопряжен с вычислительными сложностями, которые глобальные базовые модели исторически игнорировали. В Индии признаны 22 официальных региональных языка с 13 уникальными системами письменности, а в сельских районах говорят на сотнях других диалектов. Общепринятые базовые модели, обученные преимущественно на англоязычных цифровых архивах, сталкиваются с трудностями при точной токенизации, фонетической транслитерации и распознавании семантического контекста индийских языков. Собственные модели, разработанные местными специалистами, создают основу для минимизации смысловых потерь и вычислительных издержек при работе с языками Индии, обеспечивая гражданам более равный доступ к цифровым услугам.
## Предыстория
Индия на протяжении нескольких лет формировала комплексную национальную политику перехода от статуса центра ИТ-аутсорсинга к роли ведущего разработчика передовых технологий. В марте 2024 года Союзный кабинет министров утвердил масштабную программу IndiaAI Mission с многолетним бюджетом в размере 10 372 кроров индийских рупий, что эквивалентно примерно 1,25 миллиарда долларов. Ключевым направлением этих расходов стали закупка и консолидация высокопроизводительной вычислительной инфраструктуры: правительственные планы предусматривают развертывание общего государственного пула объемом не менее 10 000 графических процессоров для демократизации доступа стартапов и академических лабораторий.
Исторически колоссальная капиталоемкость обучения больших базовых моделей с нуля сосредоточила передовые разработки в руках горстки богатейших технологических гигантов из США и Китая. Циклы обучения передовых систем регулярно требуют миллионов долларов на оплату вычислительного времени, специализированных чипов памяти с высокой пропускной способностью и огромных конвейеров данных петабайтного масштаба. Вследствие этого небольшие страны и частные предприятия сталкивались с высокими экономическими барьерами для входа, зачастую ограничиваясь дообучением зарубежных базовых моделей, таких как серия LLaMA от Meta, либо лицензированием закрытых API от OpenAI и Google.
Для преодоления этой технологической асимметрии власти Индии запустили такие инициативы, как подразделение Digital India Bhashini Division, которому поручено формировать многоязычные корпуса голосовых и текстовых данных по всем официальным региональным языкам. Одновременно с этим академические учреждения, такие как Indian Institutes of Technology, совместно с венчурными студиями ранних стадий начали экспериментировать с национальными моделями, включая BharatGPT, Hanooman и Krutrim. Официальный дебют Eka-1 и семейства Dhir представляет собой институциональное продолжение этого курса, переводя национальные цели из плоскости теоретических концепций и частных демонстраций в статус официально поддерживаемых релизов.
## Реакция
Отраслевые организации, разработчики программного обеспечения и академические институты в Нью-Дели и Бангалоре внимательно следят за официальной реакцией на новые модели. Хотя официальные заявления в ходе презентации исходили в основном от секретаря S. Krishnan, широкие сообщества разработчиков в технологических центрах Индии проявили живой интерес к условиям лицензирования, архитектурной документации и доступности API для моделей Eka-1 и Dhir.
Ожидается, что структуры государственного сектора, включая National Informatics Centre и различные административные департаменты на уровне штатов, рассмотрят данные модели в качестве потенциальных кандидатов для внутренней административной автоматизации, порталов рассмотрения жалоб граждан и суммаризации документов на региональных языках. Независимые разработчики корпоративного ПО также оценивают, обеспечат ли эксплуатационные расходы на модели с двумя и пятью миллиардами параметров устойчивую альтернативу известным моделям с открытыми весами, распространяемым международными консорциумами.
Представители гражданского общества и правозащитных организаций в сфере цифровых прав, как ожидается, тщательно изучат прозрачность используемых обучающих корпусов, добиваясь официального раскрытия информации о соблюдении авторских прав на данные, лингвистической репрезентативности и методологиях устранения предвзятости на этапах обучения с подкреплением и выравнивания.
## Что пока неизвестно
В первоначальных официальных анонсах существенные технические и коммерческие подробности о трех моделях остались нераскрытыми. Министерство электроники и информационных технологий и участвующие стартапы пока не опубликовали исчерпывающие технические описания с указанием точного состава обучающих датасетов, общего числа токенов, обработанных в ходе предварительного обучения, или точных характеристик аппаратной инфраструктуры, использованной для обучения Eka-1 и серии Dhir.
Кроме того, результаты стандартных бенчмарков, сопоставляющие производительность с аналогичными системами с открытыми весами — такими как семейство LLaMA 3.2 от Meta, компактные архитектуры Mistral AI или модели Phi от Microsoft, — еще не прошли независимую проверку по стандартным критериям логического мышления, математики, написания кода и ведения многошагового диалога. Пока неизвестно, будут ли веса программного обеспечения опубликованы под полностью разрешительными открытыми лицензиями, такими как Apache 2.0 или MIT, либо же они будут распространяться по ограниченным исследовательским лицензиям, запрещающим свободное коммерческое использование. Вопросы коммерческой структуры ценообразования для корпоративного доступа к API, условия хостинга в суверенных облачных сетях и стандарты документации для разработчиков также остаются открытыми.
## За чем следить
Дальнейшая траектория развития этих моделей будет во многом зависеть от запуска полноценных порталов для разработчиков и публикации технических отчетов в ближайшие недели. Сообщество разработчиков моделей машинного обучения с открытым исходным кодом ожидает подтверждения того, загрузят ли Soket Labs и ZenteiQ чекпоинты моделей в публичные репозитории, такие как Hugging Face, что позволит мировым исследователям оценить архитектуры на стандартных наборах тестов, включая MMLU, GSM8K, а также специализированных бенчмарках для индийских языков.
Наблюдателям также предстоит следить за тем, интегрирует ли Министерство электроники и информационных технологий модели Eka-1 и Dhir в действующие приложения госсектора, такие как Unified Mobile Application for New-age Governance или платформы земельного кадастра на уровне штатов. Более широкая интеграция этих моделей с вычислительным кластером IndiaAI, в частности посредством субсидируемых государством вычислительных грантов для местных стартапов, ведущих разработки на этой базе, станет практическим индикатором их долгосрочной жизнеспособности в конкуренции с укоренившимися международными альтернативами.
Материал подготовлен на основе информации ET Online.
Источник: ET Online