L'Inde dévoile un trio de modèles de fondation d'IA nationaux pour renforcer sa technologie souveraine
Le Ministry of Electronics and IT a lancé Eka-1, Dhir 2B et Dhir 5B, conçus par les start-up locales Soket Labs et ZenteiQ, afin d'étendre l'écosystème national d'intelligence artificielle de l'Inde.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
L'Inde dévoile un trio de modèles de fondation d'IA nationaux pour renforcer sa technologie souveraine
Le Ministry of Electronics and IT a lancé Eka-1, Dhir 2B et Dhir 5B, conçus par les start-up locales Soket Labs et ZenteiQ, afin d'étendre l'écosystème national d'intelligence artificielle de l'Inde.
Cet article a été traduit automatiquement par l'IA de notre rédaction depuis l'original en anglais. Lire en anglais
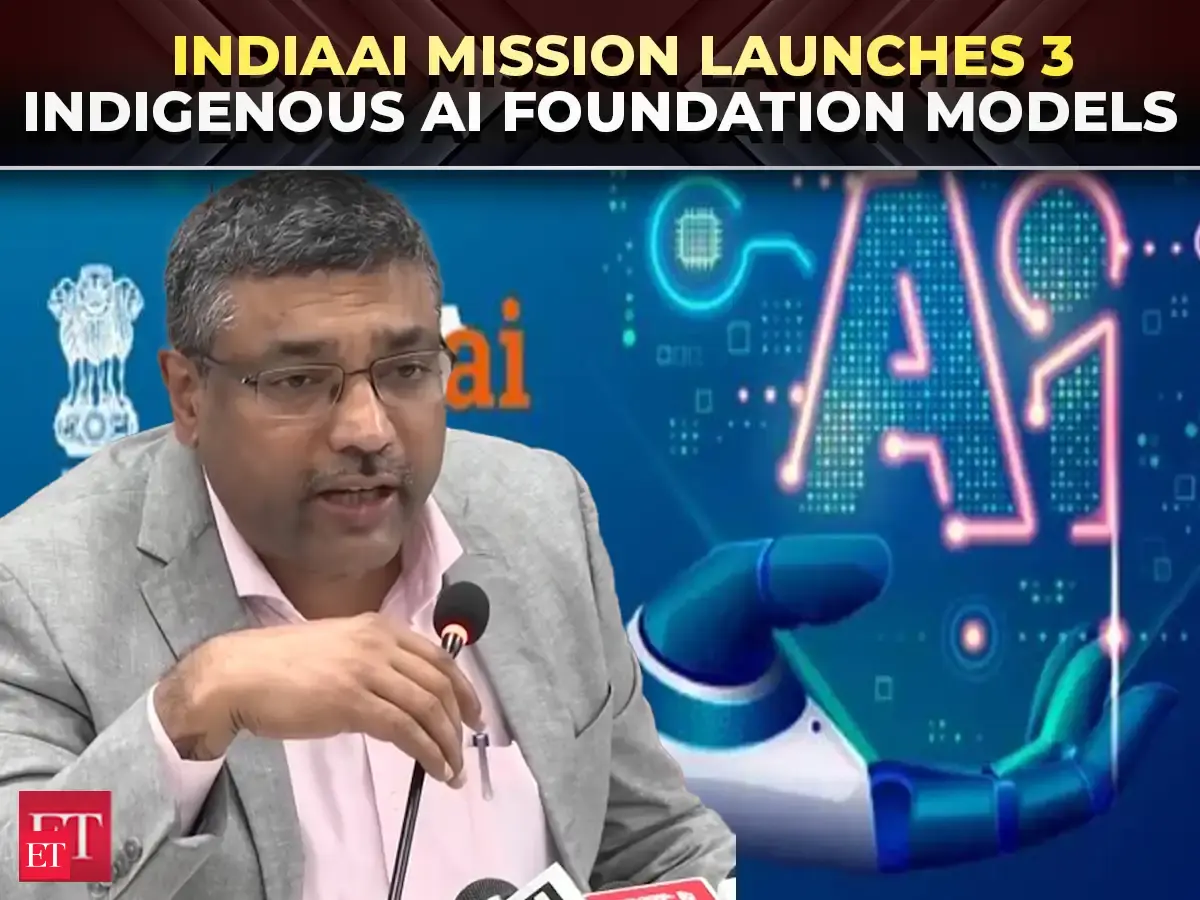
NEW DELHI — Le Ministry of Electronics and Information Technology indien a supervisé jeudi le déploiement officiel de trois modèles de fondation d'intelligence artificielle conçus localement, marquant une initiative officielle visant à établir des capacités souveraines nationales dans l'architecture fondamentale du machine learning. Les systèmes récemment introduits comprennent Eka-1, créé par Soket Labs, ainsi que Dhir 2B et Dhir 5B, développés par ZenteiQ. Dévoilée lors d'un événement ministériel officiel réunissant de hauts responsables politiques et des représentants de l'industrie, la publication de ces modèles reflète les efforts croissants de New Delhi pour réduire sa dépendance stratégique à l'égard des infrastructures informatiques importées d'Occident et de Chine, tout en adaptant les logiciels fondamentaux aux exigences multilingues et institutionnelles de l'Inde.
## Key facts
- Le Ministry of Electronics and Information Technology a supervisé le lancement de trois modèles de fondation nationaux : Eka-1, Dhir 2B et Dhir 5B. - Le modèle Eka-1 a été conçu par la start-up indienne d'intelligence artificielle Soket Labs. - Les modèles Dhir 2B et Dhir 5B, qui affichent respectivement des configurations de deux milliards et cinq milliards de paramètres, ont été produits par l'entreprise nationale ZenteiQ. - Le secrétaire à l'Électronique et aux Technologies de l'information, S. Krishnan, a présidé le lancement, décrivant ce déploiement public comme un jalon déterminant pour le programme technologique national du pays. - Cette initiative s'aligne sur le programme plus large d'intelligence artificielle souveraine de l'Inde, qui comprend des subventions publiques pour la puissance de calcul et la gestion souveraine des données.
## What happened
Lors d'une présentation dédiée organisée par le Ministry of Electronics and Information Technology, des responsables gouvernementaux et des spécialistes de la technologie se sont réunis pour inaugurer trois architectures de fondation génératives entièrement conçues par des équipes d'ingénieurs nationaux. Le secrétaire du ministère, S. Krishnan, a dirigé les travaux, présentant officiellement Eka-1 de Soket Labs ainsi que la famille de modèles Dhir 2B et Dhir 5B de ZenteiQ. S. Krishnan a souligné que la mise à disposition publique des poids et architectures de base constitue un socle structurel pour l'ingénierie logicielle indépendante à travers le sous-continent.
Les modèles occupent chacun des segments distincts au sein du paysage global du machine learning. Soket Labs a conçu Eka-1 pour répondre à des tâches fondamentales, tandis que la série Dhir de ZenteiQ cible des environnements de calcul à plus faible nombre de paramètres. Les désignations numériques de Dhir 2B et Dhir 5B correspondent à des échelles de paramètres d'environ deux milliards et cinq milliards de variables, un niveau délibérément ajusté pour l'edge computing, les déploiements à faible latence et les environnements d'inférence aux budgets contraints, plutôt que pour les gigantesques grappes de calcul de centaines de milliards de paramètres exploitées par les entreprises technologiques hyperscalers américaines.
Tout au long du lancement, les représentants du ministère ont expliqué comment l'introduction publique de ces systèmes fait le pont entre la recherche universitaire et le déploiement commercial. Plutôt que de dépendre entièrement d'interfaces logicielles applicatives construites au sommet d'interfaces de programmation externes, le ministère a mis en avant la nécessité stratégique de cultiver des architectures natives où les corpus d'entraînement, la mécanique de tokenisation et les protocoles d'alignement demeurent sous supervision nationale.
## Why it matters
L'introduction de modèles de base nationaux emporte d'importantes répercussions pour la numérisation des entreprises, la souveraineté des données et l'allocation du capital technologique national. Pendant des décennies, les économies émergentes ont principalement fonctionné comme des consommatrices d'architectures logicielles conçues à l'étranger. Dans le domaine de l'intelligence artificielle, dépendre entièrement de systèmes propriétaires gérés hors des frontières nationales crée des vulnérabilités systémiques concernant l'accès aux plateformes, les coûts de licence récurrents, la fuite de devises étrangères et les modifications soudaines de services dictées par des juridictions réglementaires étrangères.
En mettant en place des modèles de fondation fonctionnels conçus par Soket Labs et ZenteiQ, les développeurs locaux accèdent à des outils personnalisables pour des cas d'usage nationaux précis, sans devoir acheminer d'informations sensibles par des centres de données offshore. Des modèles à empreinte réduite comme Dhir 2B et Dhir 5B s'avèrent particulièrement pertinents pour les environnements professionnels décentralisés, tels que les institutions bancaires régionales, les administrations municipales et les centres de santé locaux. Ces organisations fonctionnent fréquemment sous de strictes contraintes budgétaires et sur des réseaux de télécommunications fragmentés, ce qui rend les modèles de grande taille économiquement non viables et techniquement difficiles à héberger.
De plus, le profil linguistique du sous-continent indien présente des complexités de calcul que les modèles de fondation mondiaux ont historiquement négligées. L'Inde reconnaît 22 langues régionales officielles écrites dans 13 alphabets uniques, auxquelles s'ajoutent des centaines de dialectes non répertoriés parlés dans les districts ruraux. Les modèles de fondation dominants, massivement entraînés sur des archives numériques à prédominance anglophone, peinent à assurer une tokenisation précise, une translittération phonétique adéquate et une juste interprétation du contexte sémantique lors de l'analyse des dialectes indiens. Des modèles natifs conçus par des équipes locales offrent une base pensée pour minimiser la perte sémantique et la surcharge de calcul pour les langues indiennes, favorisant un accès plus équitable des citoyens aux services numériques.
## The background
L'Inde a consacré plusieurs années à l'élaboration d'une politique nationale globale pour passer du statut de pôle d'externalisation informatique à celui de développeur de premier plan de technologies de pointe. En mars 2024, le Union Cabinet a approuvé le programme exhaustif IndiaAI Mission, doté d'une enveloppe budgétaire pluriannuelle de 10,372 crore de roupies indiennes, soit environ 1.25 billion dollars. L'un des piliers centraux de ces dépenses visait l'acquisition et la mutualisation d'infrastructures de calcul haute performance, les plans gouvernementaux prévoyant le déploiement d'un parc public partagé d'au moins 10,000 processeurs graphiques pour démocratiser l'accès des start-up et des laboratoires universitaires.
Historiquement, l'intensité capitalistique requise pour entraîner de grands modèles de fondation à partir de zéro a concentré le développement de pointe entre les mains d'une poignée de géants de la tech disposant d'importantes ressources financières, basés aux États-Unis et en Chine. Les sessions d'entraînement de pointe nécessitent habituellement des millions de dollars en temps de calcul, des puces mémoire propriétaires à large bande passante et de vastes pipelines de données à l'échelle du pétaoctet. En conséquence, les petites nations et les entreprises privées se sont heurtées à d'importantes barrières économiques à l'entrée, se résignant souvent à affiner des modèles de base étrangers comme la série LLaMA de Meta ou à acheter des licences d'API fermées auprès d'OpenAI et de Google.
Pour contrer cette asymétrie technologique, les autorités indiennes ont lancé des initiatives telles que la Digital India Bhashini Division, chargée de constituer des jeux de données textuels et vocaux multilingues dans l'ensemble des langues régionales répertoriées. Dans le même temps, des institutions universitaires comme les Indian Institutes of Technology, aux côtés de structures de capital-risque en phase d'amorçage, ont commencé à expérimenter des modèles nationaux tels que BharatGPT, Hanooman et Krutrim. L'apparition officielle d'Eka-1 aux côtés de la famille Dhir s'inscrit dans la continuité institutionnelle de cette dynamique, concrétisant les objectifs nationaux par des lancements officiellement soutenus, au-delà des cadres théoriques et des démonstrations privées.
## Reaction
Les organisations professionnelles, les développeurs de logiciels et les institutions universitaires de New Delhi et de Bengaluru suivent de près l'accueil réservé à ces nouveaux modèles. Bien que les interventions officielles lors du lancement aient été principalement menées par le secrétaire S. Krishnan, les communautés de développeurs à travers les pôles technologiques de l'Inde ont manifesté un vif intérêt pour les conditions de licence, la documentation architecturale et la disponibilité des API entourant Eka-1 et les modèles Dhir.
Les organismes du secteur public, notamment le National Informatics Centre et divers départements administratifs au niveau des États, devraient évaluer ces modèles pour de potentielles applications d'automatisation administrative interne, de portails de traitement des réclamations citoyennes et de synthèse de documents en langues régionales. Les éditeurs indépendants de logiciels d'entreprise examinent de leur côté si les coûts d'exploitation des modèles de deux milliards et cinq milliards de paramètres offrent une alternative viable aux modèles open-weight établis et distribués par des consortiums internationaux.
Les représentants de la société civile et des organisations de défense des droits numériques devraient pour leur part scruter la transparence des corpus d'entraînement sous-jacents, réclamant des informations officielles sur la conformité aux droits d'auteur, la représentativité linguistique et les méthodologies employées pour éliminer les biais au cours des phases d'apprentissage par renforcement et d'alignement.
## What we don't know yet
D'importants détails techniques et commerciaux relatifs aux trois modèles restent non confirmés à la suite des premières annonces publiques. Le Ministry of Electronics and Information Technology et les start-up partenaires n'ont pas encore publié de livres blancs techniques détaillés précisant la composition exacte des ensembles de données d'entraînement, le nombre total de jetons traités durant le pré-entraînement ou l'infrastructure matérielle précise mobilisée pour entraîner Eka-1 et la série Dhir.
De plus, les évaluations comparatives standard mesurant les performances par rapport à des systèmes équivalents à poids ouverts — tels que la gamme LLaMA 3.2 de Meta, les architectures compactes de Mistral AI ou les modèles Phi de Microsoft — n'ont pas encore été vérifiées de manière indépendante sur les critères d'évaluation habituels en matière de raisonnement, de mathématiques, de programmation et de dialogue à tours multiples. L'incertitude demeure quant à savoir si les poids des logiciels seront publiés sous des licences open-source totalement permissives, comme Apache 2.0 ou MIT, ou distribués via des licences de recherche restreintes limitant une utilisation commerciale libre. La grille tarifaire commerciale pour l'accès aux API d'entreprise, les modalités d'hébergement sur des réseaux cloud souverains et les standards de documentation pour les développeurs restent également à préciser.
## What to watch
La trajectoire immédiate de ces modèles dépendra largement du déploiement de portails complets pour les développeurs et de livres blancs techniques au cours des prochaines semaines. La communauté du machine learning open-source cherchera à vérifier si Soket Labs et ZenteiQ publieront les points de contrôle des modèles sur des dépôts publics tels que Hugging Face, permettant aux chercheurs du monde entier d'évaluer les architectures au moyen de suites de tests de référence standard comme MMLU, GSM8K et d'évaluations spécialisées dans les langues indiennes.
Les observateurs surveilleront également si le Ministry of Electronics and Information Technology intègre Eka-1 et les modèles Dhir dans des applications opérationnelles du secteur public, telles que le Unified Mobile Application for New-age Governance ou les plateformes foncières des États. L'intégration plus large de ces modèles au cluster de calcul IndiaAI, notamment par l'attribution de crédits de calcul subventionnés par l'État pour les start-up locales développant sur ces bases, constituera un indicateur concret de leur viabilité à long terme face aux solutions internationales bien établies.
Ce rapport est basé sur des informations initialement publiées par ET Online.
Source : ET Online