India presenta un trío de modelos fundacionales de IA nacionales para impulsar su tecnología soberana
El Ministry of Electronics and IT presentó Eka-1, Dhir 2B y Dhir 5B, desarrollados por las startups nacionales Soket Labs y ZenteiQ, para expandir el ecosistema doméstico de inteligencia artificial de India.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
India presenta un trío de modelos fundacionales de IA nacionales para impulsar su tecnología soberana
El Ministry of Electronics and IT presentó Eka-1, Dhir 2B y Dhir 5B, desarrollados por las startups nacionales Soket Labs y ZenteiQ, para expandir el ecosistema doméstico de inteligencia artificial de India.
Este artículo fue traducido automáticamente por la IA de nuestra redacción desde el original en inglés. Leer en inglés
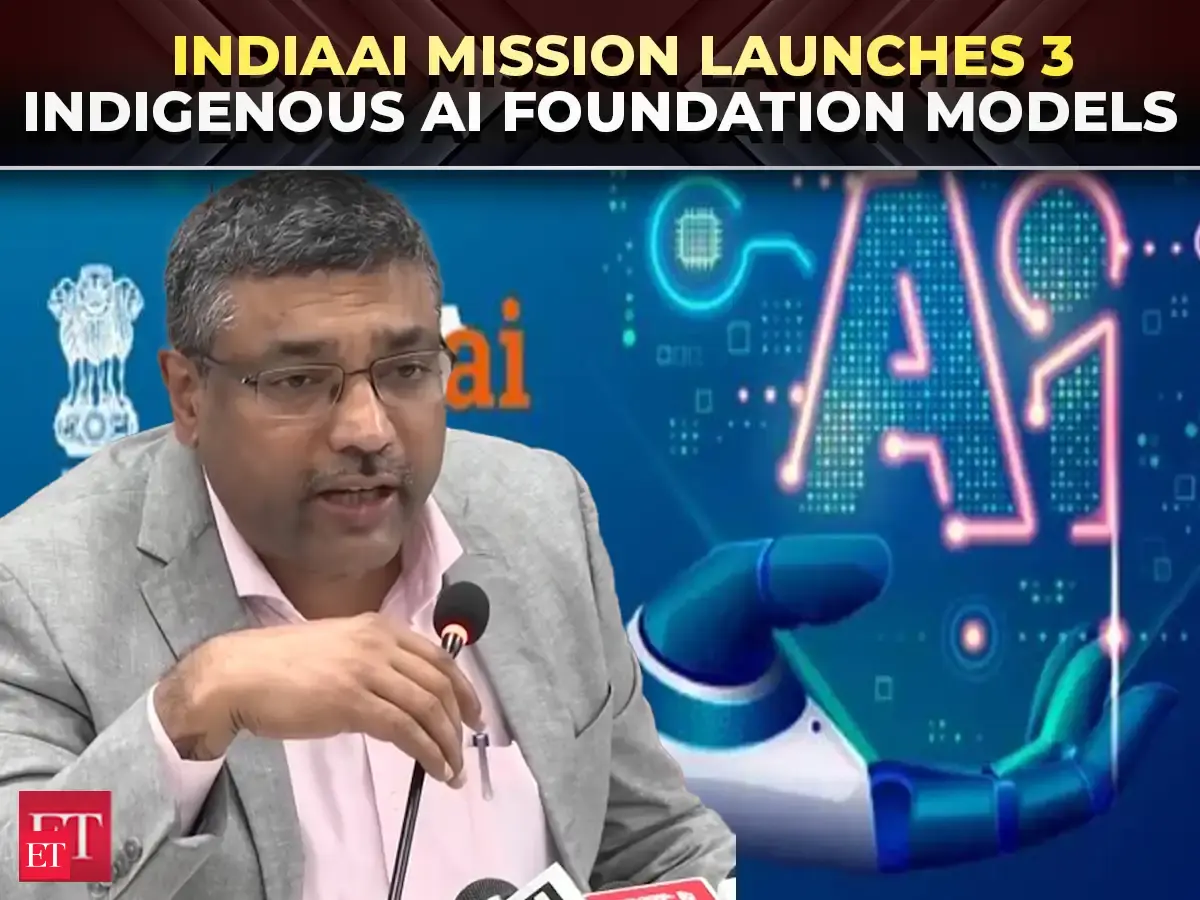
NUEVA DELHI — El Ministry of Electronics and Information Technology de India supervisó el jueves el despliegue formal de tres modelos fundacionales de inteligencia artificial de desarrollo nacional, lo que marca un impulso oficial para establecer capacidades soberanas domésticas en la arquitectura central de aprendizaje automático. Los sistemas recién presentados incluyen Eka-1, creado por Soket Labs, junto con Dhir 2B y Dhir 5B, desarrollados por ZenteiQ. Presentados durante un acto ministerial oficial al que asistieron altos responsables políticos y representantes de la industria, el lanzamiento público de los modelos refleja un creciente esfuerzo de New Delhi por reducir la dependencia estratégica de los marcos computacionales importados de Occidente y China, adaptando al mismo tiempo el software fundacional a los requisitos multilingües e institucionales de India.
## Datos clave
- El Ministry of Electronics and Information Technology supervisó el lanzamiento de tres modelos fundacionales nacionales: Eka-1, Dhir 2B y Dhir 5B. - El modelo Eka-1 fue diseñado por la startup india de inteligencia artificial Soket Labs. - Los modelos Dhir 2B y Dhir 5B, con configuraciones de dos mil millones y cinco mil millones de parámetros respectivamente, fueron producidos por la firma nacional ZenteiQ. - El secretario de Electronics and Information Technology, S. Krishnan, presidió el lanzamiento y describió el despliegue público como un hito crítico para la agenda tecnológica nacional del país. - La iniciativa se alinea con el programa más amplio de inteligencia artificial soberana de India, que incluye subsidios públicos a la computación y la custodia de datos locales.
## Qué ocurrió
Durante una presentación especial organizada por el Ministry of Electronics and Information Technology, funcionarios gubernamentales y tecnólogos se reunieron para inaugurar tres arquitecturas fundacionales generativas construidas íntegramente por equipos de ingeniería locales. El secretario del ministerio, S. Krishnan, encabezó los actos presentando formalmente Eka-1 de Soket Labs, así como la familia de modelos Dhir 2B y Dhir 5B de ZenteiQ. Krishnan enfatizó que poner a disposición pública los pesos y las arquitecturas fundacionales sirve como una base estructural para la ingeniería de software independiente en todo el subcontinente.
Los modelos ocupan distintos segmentos dentro del panorama general del aprendizaje automático. Soket Labs diseñó Eka-1 para abordar tareas fundacionales, mientras que la serie Dhir de ZenteiQ está orientada a entornos computacionales de menor número de parámetros. Las designaciones numéricas de Dhir 2B y Dhir 5B representan escalas de parámetros de aproximadamente dos mil millones y cinco mil millones de variables, un nivel deliberadamente ajustado para la computación en el borde (edge computing), despliegues de baja latencia y entornos de inferencia con restricciones de costos, en lugar de los clústeres masivos de cientos de miles de millones de parámetros que mantienen las corporaciones tecnológicas hiperescalares estadounidenses.
A lo largo de la presentación, los funcionarios del ministerio explicaron cómo el debut público de estos sistemas tiende un puente entre la investigación académica y la implementación comercial. En lugar de depender exclusivamente de envoltorios en la capa de aplicación construidos sobre interfaces de programación de aplicaciones externas, el ministerio destacó la necesidad estratégica de cultivar arquitecturas nativas donde los corpus de entrenamiento, la mecánica de tokenización y los protocolos de alineación permanezcan bajo supervisión nacional.
## Por qué es importante
La introducción de modelos base nacionales conlleva amplias ramificaciones para la digitalización empresarial, la soberanía de los datos y la asignación del capital tecnológico nacional. Durante décadas, las economías emergentes han operado predominantemente como consumidoras de arquitecturas de software desarrolladas en el extranjero. En el ámbito de la inteligencia artificial, depender por completo de sistemas propietarios mantenidos fuera de las fronteras nacionales crea vulnerabilidades sistémicas en relación con el acceso a las plataformas, los gastos recurrentes en licencias, la fuga de divisas y las modificaciones abruptas del servicio regidas por jurisdicciones regulatorias extranjeras.
Al establecer modelos fundacionales funcionales desarrollados por Soket Labs y ZenteiQ, los desarrolladores locales obtienen acceso a herramientas que pueden personalizarse para casos de uso específicos del país sin necesidad de canalizar información confidencial a través de centros de datos en el extranjero. Los modelos de menor tamaño como Dhir 2B y Dhir 5B son especialmente pertinentes para entornos empresariales descentralizados, como instituciones bancarias regionales, órganos de administración municipal y clínicas locales de salud. Estas organizaciones operan con frecuencia bajo estrictas limitaciones presupuestarias y redes de telecomunicaciones fragmentadas, lo que hace que los modelos masivos sean económicamente inviables y técnicamente impracticables de alojar.
Además, el perfil lingüístico del subcontinente indio plantea complejidades computacionales que los modelos fundacionales globales han desatendido históricamente. India reconoce 22 idiomas regionales oficiales escritos en 13 alfabetos únicos, con cientos de dialectos no oficiales hablados en los distritos rurales. Los modelos fundacionales convencionales, entrenados abrumadoramente con archivos digitales dominados por el inglés, tienen dificultades con la tokenización precisa, la transliteración fonética y el contexto semántico al procesar las lenguas vernáculas índicas. Los modelos nativos construidos por equipos locales proporcionan una base diseñada para minimizar la pérdida semántica y la sobrecarga computacional para las lenguas indias, facilitando un acceso ciudadano más equitativo a los servicios digitales.
## Contexto
India ha dedicado varios años a formular una política nacional integral para pasar de ser un centro de externalización de TI a un desarrollador de primer orden de tecnologías de frontera. En marzo de 2024, el Union Cabinet aprobó la amplia IndiaAI Mission con una asignación presupuestaria plurianual de 10,372 crore Indian rupees, equivalente a aproximadamente 1.25 billion dollars. Un pilar central de ese gasto se destinó a la adquisición y agregación de infraestructura de computación de alto rendimiento, con planes gubernamentales orientados a desplegar un fondo público compartido de al menos 10,000 unidades de procesamiento gráfico para democratizar el acceso de startups y laboratorios académicos.
Históricamente, la intensidad de capital requerida para entrenar grandes modelos fundacionales desde cero ha concentrado el desarrollo de vanguardia en un reducido número de gigantes tecnológicos con grandes recursos económicos basados en Estados Unidos y China. Los ciclos de entrenamiento de frontera exigen habitualmente millones de dólares en tiempo de cómputo, chips de memoria de alto ancho de banda propietarios y vastos canales de datos a escala de petabytes. En consecuencia, las naciones más pequeñas y las empresas privadas se enfrentaban a pronunciadas barreras económicas de entrada, resignándose a menudo a ajustar modelos base extranjeros como la serie LLaMA de Meta o a contratar licencias de API cerradas de OpenAI y Google.
Para contrarrestar esta asimetría tecnológica, las autoridades indias introdujeron iniciativas como la Digital India Bhashini Division, encargada de compilar conjuntos de datos multilingües de voz y texto en todos los idiomas regionales oficiales. Al mismo tiempo, instituciones académicas como los Indian Institutes of Technology, junto con fondos de inversión en etapas iniciales, comenzaron a experimentar con modelos nacionales como BharatGPT, Hanooman y Krutrim. El debut oficial de Eka-1 junto a la familia Dhir representa una continuación institucional de este impulso, trasladando los objetivos nacionales desde marcos teóricos y demostraciones privadas hacia lanzamientos respaldados oficialmente.
## Reacciones
Organizaciones del sector, desarrolladores de software e instituciones académicas en New Delhi y Bengaluru siguen de cerca la acogida oficial de los nuevos modelos. Si bien las declaraciones oficiales durante el acto de lanzamiento estuvieron encabezadas por el secretario S. Krishnan, redes más amplias de desarrolladores a lo largo de los centros tecnológicos de India han manifestado gran interés en las condiciones de licenciamiento, la documentación técnica y la disponibilidad de API para Eka-1 y los modelos Dhir.
Se prevé que organismos del sector público, entre ellos el National Informatics Centre y varios departamentos administrativos a nivel estatal, evalúen los modelos como potenciales candidatos para la automatización administrativa interna, portales de atención de quejas ciudadanas y resúmenes de documentos en idiomas regionales. De forma similar, desarrolladores independientes de software empresarial están analizando si los costos operativos de los modelos de dos mil millones y cinco mil millones de parámetros ofrecen una alternativa sostenible frente a los pesos abiertos ya consolidados que distribuyen consorcios internacionales.
Se anticipa que representantes de la sociedad civil y de organizaciones de derechos digitales examinen la transparencia de los corpus de entrenamiento subyacentes, buscando divulgaciones formales sobre el cumplimiento de los derechos de autor de los datos, la representatividad lingüística y las metodologías empleadas para eliminar sesgos durante las fases de aprendizaje por refuerzo y alineación.
## Lo que aún no se sabe
Importantes detalles técnicos y comerciales sobre los tres modelos permanecen sin verificar tras los anuncios públicos iniciales. El Ministry of Electronics and Information Technology y las startups participantes aún no han publicado informes técnicos exhaustivos que especifiquen la composición exacta de los conjuntos de datos de entrenamiento, el recuento total de tokens procesados durante el preentrenamiento o la infraestructura precisa de hardware utilizada para entrenar Eka-1 y la serie Dhir.
Asimismo, las evaluaciones de referencia estándar que miden el rendimiento frente a sistemas comparables de pesos abiertos —como la familia LLaMA 3.2 de Meta, las arquitecturas compactas de Mistral AI o los modelos Phi de Microsoft— todavía no han sido verificadas de manera independiente en pruebas estándar de razonamiento, matemáticas, programación y conversación en múltiples turnos. Sigue siendo incierto si los pesos del software se publicarán bajo licencias de código abierto totalmente permisivas, como Apache 2.0 o MIT, o si se distribuirán mediante licencias de investigación restringidas que limiten el uso comercial sin restricciones. La estructura comercial de precios para el acceso a API empresariales, los acuerdos de alojamiento en redes de nube soberana y los estándares de documentación para desarrolladores tampoco se han detallado.
## A qué prestar atención
La trayectoria inmediata de estos modelos dependerá en gran medida del lanzamiento de portales integrales para desarrolladores y de informes técnicos durante las próximas semanas. La comunidad de aprendizaje automático de código abierto estará atenta para comprobar si Soket Labs y ZenteiQ suben los puntos de control (checkpoints) de los modelos a repositorios públicos como Hugging Face, lo que permitiría a investigadores globales evaluar las arquitecturas frente a baterías de pruebas estándar como MMLU, GSM8K y evaluaciones especializadas en lenguas índicas.
Los observadores también deberán seguir de cerca si el Ministry of Electronics and Information Technology integra Eka-1 y los modelos Dhir en aplicaciones activas del sector público, como la Unified Mobile Application for New-age Governance o las plataformas estatales de registros territoriales. La integración más amplia de estos modelos con el clúster computacional de IndiaAI, en particular mediante créditos de cómputo subsidiados por el gobierno para startups locales que desarrollen sobre estas bases, servirá como indicador práctico de su viabilidad a largo plazo frente a las consolidadas alternativas internacionales.
Este informe se basa en la cobertura original publicada por ET Online.
Fuente: ET Online