Índia apresenta trio de modelos de fundação de IA domésticos para fortalecer tecnologia soberana
O Ministério da Eletrônica e TI lançou o Eka-1, o Dhir 2B e o Dhir 5B, desenvolvidos pelas startups locais Soket Labs e ZenteiQ, para expandir o ecossistema doméstico de inteligência artificial da Índia.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Índia apresenta trio de modelos de fundação de IA domésticos para fortalecer tecnologia soberana
O Ministério da Eletrônica e TI lançou o Eka-1, o Dhir 2B e o Dhir 5B, desenvolvidos pelas startups locais Soket Labs e ZenteiQ, para expandir o ecossistema doméstico de inteligência artificial da Índia.
Este artigo foi traduzido automaticamente pela IA da nossa redação a partir do original em inglês. Ler em inglês
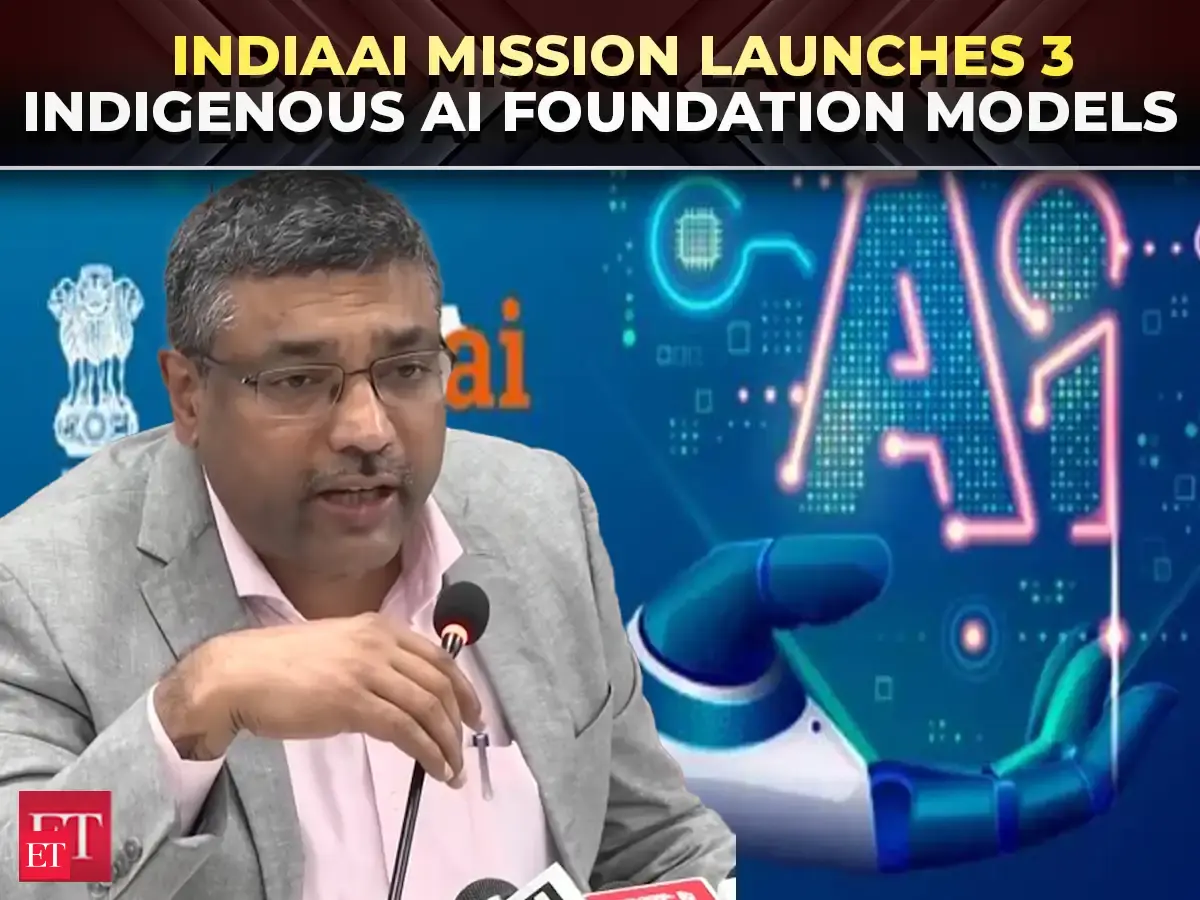
NOVA DÉLHI — O Ministério da Eletrônica e Tecnologia da Informação da Índia supervisionou na quinta-feira o lançamento formal de três modelos de fundação de inteligência artificial desenvolvidos no país, marcando um esforço oficial para estabelecer capacidades soberanas domésticas em arquitetura central de aprendizado de máquina. Os sistemas recém-apresentados incluem o Eka-1, criado pela Soket Labs, além do Dhir 2B e do Dhir 5B, desenvolvidos pela ZenteiQ. Apresentado durante um evento oficial do ministério com a presença de formuladores de políticas seniores e representantes do setor, o lançamento público dos modelos reflete um esforço crescente de Nova Délhi para reduzir a dependência estratégica de frameworks computacionais ocidentais e chineses importados, adaptando o software fundacional aos requisitos multilíngues e institucionais da Índia.
## Principais fatos
- O Ministério da Eletrônica e Tecnologia da Informação supervisionou o lançamento de três modelos de fundação domésticos: Eka-1, Dhir 2B e Dhir 5B. - O modelo Eka-1 foi desenvolvido pela startup indiana de inteligência artificial Soket Labs. - Os modelos Dhir 2B e Dhir 5B, que refletem configurações de dois bilhões e cinco bilhões de parâmetros, respectivamente, foram produzidos pela empresa nacional ZenteiQ. - O secretário de Eletrônica e Tecnologia da Informação, S. Krishnan, presidiu o lançamento, descrevendo a implantação pública como um marco crítico para a agenda tecnológica nacional do país. - A iniciativa está alinhada ao programa mais amplo de inteligência artificial soberana da Índia, que inclui subsídios públicos para computação e gestão doméstica de dados.
## O que aconteceu
Durante uma apresentação dedicada organizada pelo Ministério da Eletrônica e Tecnologia da Informação, autoridades governamentais e especialistas em tecnologia se reuniram para inaugurar três arquiteturas de fundação generativas construídas inteiramente por equipes de engenharia locais. O secretário do ministério, S. Krishnan, liderou os trabalhos, apresentando formalmente o Eka-1, da Soket Labs, bem como a família de modelos Dhir 2B e Dhir 5B, da ZenteiQ. Krishnan enfatizou que tornar os pesos e arquiteturas fundacionais acessíveis ao público serve como uma base estrutural para a engenharia de software independente em todo o subcontinente.
Os modelos em si ocupam segmentos distintos no panorama mais amplo de aprendizado de máquina. A Soket Labs projetou o Eka-1 para lidar com tarefas fundamentais, enquanto a série Dhir, da ZenteiQ, atende a ambientes de computação com menor número de parâmetros. As designações numéricas para Dhir 2B e Dhir 5B significam escalas de parâmetros de aproximadamente dois bilhões e cinco bilhões de variáveis, uma faixa intencionalmente ajustada para computação de borda, implantações de baixa latência e ambientes de inferência com restrições de custo, em vez dos clusters massivos de centenas de bilhões de parâmetros mantidos pelas corporações tecnológicas de hiperescala norte-americanas.
Ao longo do lançamento, autoridades do ministério delinearam como a estreia pública desses sistemas aproxima a pesquisa acadêmica da implantação comercial. Em vez de depender inteiramente de wrappers na camada de aplicação construídos sobre interfaces de programação de aplicações externas, o ministério destacou a necessidade estratégica de cultivar arquiteturas nativas nas quais os corpora de treinamento, a mecânica de tokenização e os protocolos de alinhamento permaneçam sob supervisão doméstica.
## Por que isso importa
A introdução de modelos de base domésticos traz amplas ramificações para a digitalização corporativa, a soberania de dados e a alocação de capital tecnológico nacional. Durante décadas, economias emergentes operaram predominantemente como consumidoras de arquiteturas de software construídas no exterior. No domínio da inteligência artificial, depender inteiramente de sistemas proprietários mantidos fora das fronteiras nacionais cria vulnerabilidades sistêmicas quanto ao acesso a plataformas, despesas recorrentes com licenciamento, fuga de divisas e modificações abruptas de serviços regidas por jurisdições regulatórias estrangeiras.
Ao estabelecer modelos de fundação funcionais desenvolvidos pela Soket Labs e pela ZenteiQ, os desenvolvedores locais ganham acesso a ferramentas que podem ser personalizadas para casos de uso domésticos específicos sem encaminhar informações proprietárias por meio de data centers no exterior. Modelos com pegada menor, como o Dhir 2B e o Dhir 5B, são particularmente relevantes para ambientes corporativos descentralizados, como instituições bancárias regionais, órgãos de governança municipal e clínicas de saúde locais. Essas organizações frequentemente operam sob rígidas limitações orçamentárias e redes de telecomunicações fragmentadas, tornando os modelos massivos economicamente inviáveis e tecnicamente impraticáveis de hospedar.
Além disso, o perfil linguístico do subcontinente indiano apresenta complexidades computacionais que os modelos de fundação globais historicamente negligenciam. A Índia reconhece 22 línguas regionais oficiais escritas em 13 alfabetos distintos, com centenas de dialetos não oficiais falados em distritos rurais. Os principais modelos de fundação, treinados esmagadoramente em arquivos digitais dominados pelo inglês, enfrentam dificuldades com tokenização precisa, transliteração fonética e contexto semântico ao analisar vernáculos índicos. Modelos nativos construídos por equipes locais fornecem uma base projetada para minimizar a perda semântica e a sobrecarga computacional para os idiomas indianos, permitindo um acesso mais equitativo dos cidadãos aos serviços digitais.
## Contexto
A Índia passou vários anos formulando uma política nacional abrangente para fazer a transição de um polo de terceirização de TI para um desenvolvedor primário de tecnologias de fronteira. Em março de 2024, o Gabinete da União sancionou a abrangente IndiaAI Mission com uma dotação orçamentária plurianual de 10.372 crore de rúpias indianas, o equivalente a aproximadamente 1,25 bilhão de dólares. Um pilar central desse gasto visava à aquisição e agregação de infraestrutura de computação de alto desempenho, com planos governamentais visando implantar um pool público compartilhado de pelo menos 10.000 unidades de processamento gráfico para democratizar o acesso de startups e laboratórios acadêmicos.
Historicamente, a intensidade de capital necessária para treinar grandes modelos de fundação do zero concentrou o desenvolvimento de fronteira em um punhado de gigantes de tecnologia com recursos abundantes sediadas nos Estados Unidos e na China. Rodadas de treinamento de fronteira rotineiramente exigem milhões de dólares em tempo de computação, chips de memória de alta largura de banda proprietários e vastos pipelines de dados em escala de petabytes. Consequentemente, nações menores e empresas privadas enfrentaram barreiras econômicas íngremes de entrada, muitas vezes se resignando a ajustar modelos-base estrangeiros, como a série LLaMA da Meta, ou a licenciar APIs fechadas da OpenAI e do Google.
Para combater essa assimetria tecnológica, as autoridades indianas introduziram iniciativas como a Digital India Bhashini Division, encarregada de reunir conjuntos de dados multilíngues de fala e texto em todos os idiomas regionais oficiais. Simultaneamente, instituições acadêmicas, como os Indian Institutes of Technology, ao lado de estúdios de capital de risco em estágio inicial, começaram a experimentar modelos nacionais como BharatGPT, Hanooman e Krutrim. A estreia oficial do Eka-1 ao lado da família Dhir representa uma continuação institucional desse esforço, transferindo os objetivos nacionais de estruturas teóricas e demonstrações privadas para lançamentos oficialmente apoiados.
## Repercussão
Organizações do setor, desenvolvedores de software e instituições acadêmicas em Nova Délhi e Bengaluru estão acompanhando de perto a recepção oficial dos novos modelos. Embora as respostas oficiais durante o evento de lançamento tenham sido ancoradas pelo secretário S. Krishnan, redes mais amplas de desenvolvedores nos polos de tecnologia da Índia manifestaram grande interesse nos termos de licenciamento, na documentação arquitetônica e na disponibilidade de APIs para o Eka-1 e os modelos Dhir.
Espera-se que órgãos do setor público, incluindo o National Informatics Centre e vários departamentos administrativos estaduais, avaliem os modelos como potenciais candidatos para automação administrativa interna, portais de atendimento a reivindicações de cidadãos e sumarização de documentos em línguas regionais. Desenvolvedores independentes de software corporativo estão avaliando de maneira semelhante se os custos operacionais dos modelos de dois bilhões e cinco bilhões de parâmetros oferecem uma alternativa sustentável aos pesos abertos já estabelecidos e distribuídos por consórcios internacionais.
Prevê-se que representantes da sociedade civil e de organizações de direitos digitais examinem a transparência dos corpora de treinamento subjacentes, buscando divulgações formais sobre conformidade com direitos autorais de dados, representatividade linguística e as metodologias empregadas para eliminar vieses durante as fases de aprendizado por reforço e alinhamento.
## O que ainda não sabemos
Detalhes técnicos e comerciais significativos sobre os três modelos continuam não verificados nos anúncios públicos iniciais. O Ministério da Eletrônica e Tecnologia da Informação e as startups participantes ainda não publicaram white papers técnicos exaustivos especificando a composição exata dos conjuntos de dados de treinamento, as contagens totais de tokens ingeridos durante o pré-treinamento ou a infraestrutura de hardware precisa utilizada para treinar o Eka-1 e a série Dhir.
Além disso, avaliações de benchmarks padrão que medem o desempenho em comparação com sistemas de pesos abertos comparáveis — como a família LLaMA 3.2 da Meta, as arquiteturas compactas da Mistral AI ou os modelos Phi da Microsoft — ainda não foram verificadas de forma independente em critérios padronizados de raciocínio, matemática, codificação e conversação multiturno. Permanece incerto se os pesos do software serão publicados sob licenças de código aberto totalmente permissivas, como Apache 2.0 ou MIT, ou distribuídos por meio de licenças de pesquisa restritas que limitam o uso comercial irrestrito. A estrutura de preços comerciais para acesso de empresas via API, os acordos de hospedagem em redes de nuvem soberanas e os padrões de documentação para desenvolvedores também continuam indefinidos.
## O que acompanhar
A trajetória imediata desses modelos dependerá fortemente do lançamento de portais abrangentes para desenvolvedores e de white papers técnicos ao longo das próximas semanas. A comunidade de aprendizado de máquina de código aberto buscará verificar se a Soket Labs e a ZenteiQ enviarão os checkpoints dos modelos para repositórios públicos como o Hugging Face, permitindo que pesquisadores globais avaliem as arquiteturas em relação a suítes de benchmark padrão como MMLU, GSM8K e avaliações especializadas em línguas índicas.
Os observadores também devem acompanhar se o Ministério da Eletrônica e Tecnologia da Informação integrará o Eka-1 e os modelos Dhir a aplicações ativas do setor público, como o Unified Mobile Application for New-age Governance ou plataformas estaduais de registros de terras. A integração mais ampla desses modelos com o cluster de computação da IndiaAI, particularmente por meio de créditos de computação subsidiados pelo governo para startups locais que constroem sobre essas bases, servirá como um indicador prático de sua viabilidade a longo prazo frente a alternativas internacionais consolidadas.
Esta reportagem baseia-se na cobertura original publicada pelo ET Online.
Fonte: ET Online