Netflix revela grafo de conhecimento de telemetria impulsionado por IA para gerenciar 38 milhões de eventos por segundo
Os engenheiros Prasanna Vijayanathan e Renzo Sanchez-Silva detalham a transição do monitoramento reativo para fluxos de trabalho agênticos baseados no Claude em dados unificados de MELT.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Netflix revela grafo de conhecimento de telemetria impulsionado por IA para gerenciar 38 milhões de eventos por segundo
Os engenheiros Prasanna Vijayanathan e Renzo Sanchez-Silva detalham a transição do monitoramento reativo para fluxos de trabalho agênticos baseados no Claude em dados unificados de MELT.
Este artigo foi traduzido automaticamente pela IA da nossa redação a partir do original em inglês. Ler em inglês
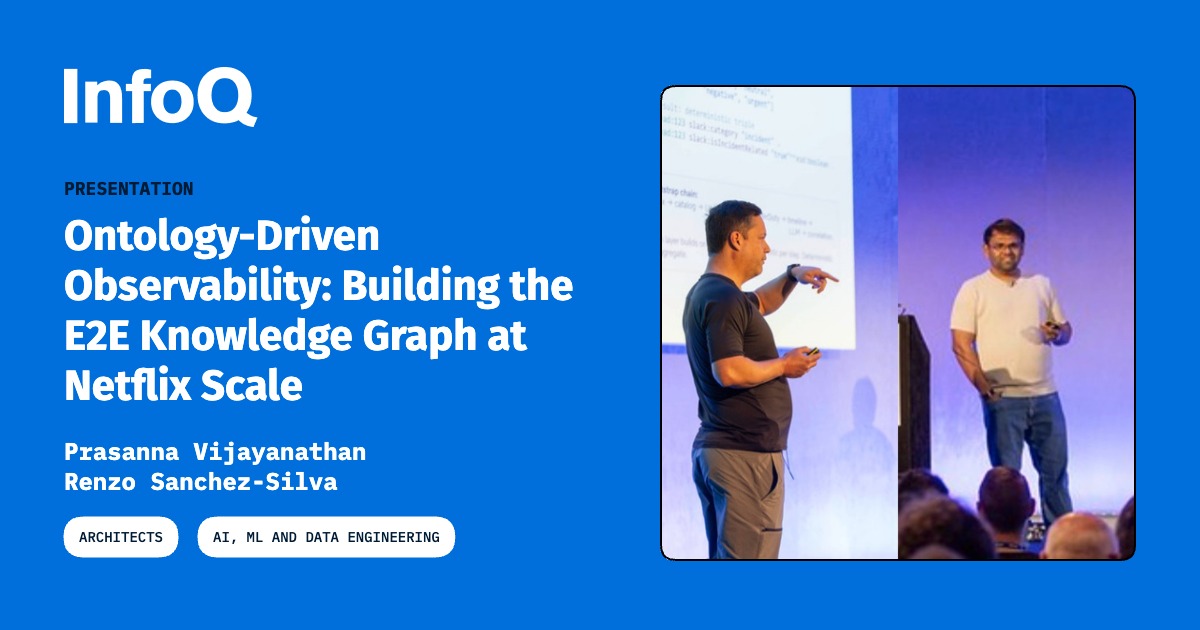
Em 9 de outubro de 2026, os engenheiros da Netflix Prasanna Vijayanathan e Renzo Sanchez-Silva publicaram detalhes de uma grande evolução arquitetônica na infraestrutura de telemetria da gigante do streaming, revelando como a plataforma gerencia o monitoramento em tempo real de 38 milhões de eventos por segundo. O comunicado técnico descreveu a transição de estruturas tradicionais de monitoramento reativo para uma ontologia operacional impulsionada por IA. Ao unificar métricas, eventos, logs e rastreamentos (traces) — coletivamente conhecidos como telemetria MELT — em um grafo de conhecimento ponta a ponta consultável, a Netflix integrou fluxos de trabalho de inteligência artificial agêntica utilizando o modelo Claude da Anthropic ao lado de arquiteturas de banco de dados em grafo. A implementação visa transformar a maneira como uma das maiores operações nativas em nuvem do mundo identifica dependências de sistema, diagnostica causas-raiz e gerencia modos de falha complexos em milhares de microsserviços.
## Principais fatos - Os engenheiros da Netflix Prasanna Vijayanathan e Renzo Sanchez-Silva apresentaram a nova arquitetura de observabilidade da empresa em 9 de outubro de 2026. - A plataforma ingere e processa telemetria em um volume de 38 milhões de eventos por segundo em toda a infraestrutura global da Netflix. - O sistema unifica quatro pilares fundamentais da telemetria — Métricas, Eventos, Logs e Rastreamentos (MELT) — em um único grafo de conhecimento consultável. - O modelo operacional realiza a transição da Netflix do monitoramento reativo para uma ontologia impulsionada por IA, usando bancos de dados em grafo e fluxos de trabalho de IA agêntica baseados no Claude. - A atualização arquitetônica visa o raciocínio contextual automatizado ponta a ponta para isolar anomalias operacionais em serviços distribuídos profundamente interconectados.
## O que aconteceu De acordo com os detalhes divulgados pelos engenheiros Prasanna Vijayanathan e Renzo Sanchez-Silva, a Netflix concluiu uma reformulação fundamental de sua arquitetura de observabilidade corporativa, abordando a complexidade operacional de lidar com 38 milhões de eventos de telemetria por segundo. Historicamente, grandes plataformas em nuvem dependiam de pilhas de monitoramento fragmentadas, onde métricas, registros de log, rastreamentos de aplicações e eventos discretos do sistema eram armazenados em silos de dados separados, exigindo que operadores humanos cruzassem informações manualmente entre painéis durante interrupções operacionais.
Sob o novo paradigma detalhado por Vijayanathan e Sanchez-Silva, a Netflix consolidou esses fluxos díspares de telemetria — Métricas, Eventos, Logs e Rastreamentos (MELT) — em uma ontologia operacional centralizada. Essa ontologia modela os relacionamentos, as dependências e o fluxo de dados em todo o ecossistema de microsserviços da plataforma. Ao representar componentes de infraestrutura, aplicações de software e fluxos de rede como nós e arestas em um banco de dados em grafo especializado, a estrutura cria um grafo de conhecimento vivo e ponta a ponta do ambiente de execução da plataforma.
Para operacionalizar esse grafo em escala, a Netflix integrou fluxos de trabalho de inteligência artificial agêntica utilizando o modelo de linguagem Claude, da Anthropic. Em vez de depender apenas de alertas estáticos por limite de tolerância ou consultas iniciadas por humanos, o sistema implanta agentes de IA que consultam o grafo de conhecimento de forma autônoma quando ocorrem anomalias. Esses agentes percorrem caminhos de rede, correlacionam IDs de rastreamento com picos de log e desvios de métricas, e constroem explicações contextuais de falhas de sistema. Segundo a publicação técnica, essa abordagem agêntica possibilita a análise automatizada de causa-raiz ao permitir que sistemas de IA raciocinem diretamente sobre a topologia estrutural contínua da pegada global de serviços da Netflix.
## Por que isso importa A transição para um grafo de observabilidade guiado por ontologia representa uma mudança estrutural na forma como sistemas de software corporativos em grande escala são mantidos, trazendo implicações diretas para os padrões de engenharia em nuvem, práticas de engenharia de confiabilidade de sites (SRE) e estratégias corporativas de implementação de IA.
Em uma escala de processamento de 38 milhões de eventos por segundo, a resposta a incidentes tradicional dependente de intervenção humana (human-in-the-loop) enfrenta severas limitações físicas. Na arquitetura em nuvem moderna, uma única solicitação de usuário pode disparar centenas de chamadas subsequentes em microsserviços responsáveis por autenticação de usuário, algoritmos de recomendação, codificação de vídeo, metadados de catálogo e redes de distribuição de conteúdo. Quando ocorre uma falha, tempestades de alertas costumam inundar os centros de operações com milhares de avisos simultâneos, criando um problema de sinal-ruído que atrasa o tempo médio de resolução (MTTR).
Ao substituir conjuntos de regras estáticas por um grafo de conhecimento MELT unificado e pelo raciocínio de IA agêntica, a Netflix combate a latência inerente ao diagnóstico humano. A capacidade de um agente de IA, alimentado por modelos como o Claude, de consultar programaticamente um banco de dados em grafo em tempo real significa que o mapeamento contextual da causa-raiz pode ocorrer em segundos, em vez de horas. Para organizações de software corporativo, isso demonstra uma implementação concreta de IA generativa em produção além das interfaces de chatbot, provando a utilidade de grandes modelos de linguagem como motores de raciocínio operacional capazes de navegar por topologias de sistema complexas.
Além disso, essa implementação estabelece uma referência para o gerenciamento de infraestruturas em nuvem. À medida que empresas nos setores de serviços financeiros, logística e telecomunicações gerenciam ambientes multinuvem cada vez mais complexos, a integração de ontologias de telemetria unificadas com agentes autônomos de IA tende a se tornar a arquitetura padrão para sistemas de alta disponibilidade.
## O contexto Para entender a importância da atualização técnica da Netflix, é necessário examinar a evolução da arquitetura nativa em nuvem nas últimas duas décadas. A Netflix foi uma das pioneiras na migração para a nuvem, transferindo toda a sua plataforma de streaming de data centers privados para a Amazon Web Services (AWS) entre 2008 e 2016. Durante essa migração, a Netflix popularizou a arquitetura de microsserviços, fracionando softwares monolíticos em milhares de serviços independentes e especializados que se comunicam por meio de APIs de rede.
Embora os microsserviços tenham proporcionado escalabilidade e velocidade de implantação sem precedentes, eles criaram uma complexidade operacional inédita. Em uma aplicação monolítica tradicional, a depuração envolve analisar uma única pilha de chamadas e um arquivo de log local. Em um ecossistema de microsserviços, um pico transiente de latência em um cluster de banco de dados pode se propagar por dezenas de serviços dependentes, causando falhas em cascata difíceis de rastrear até a origem.
Para gerenciar essa complexidade, a indústria de software desenvolveu a estrutura de telemetria MELT: - Métricas: Representações numéricas de dados medidos ao longo de intervalos de tempo, como utilização de CPU, consumo de memória ou contagem de requisições por segundo. - Eventos: Registros discretos e imutáveis de ações específicas que ocorrem em um momento no tempo, como uma implantação de código, reinicialização de servidor ou login de usuário. - Logs: Saídas de texto detalhadas emitidas por aplicações de software contendo detalhes contextuais com marcação de tempo sobre a execução em tempo de execução. - Rastreamentos: Registros ponta a ponta que acompanham o ciclo de vida de uma requisição individual à medida que ela trafega por múltiplos microsserviços e limites de rede.
Apesar da adoção dos padrões MELT, a maioria dos ambientes corporativos mantinha esses quatro tipos de dados em bancos de dados isolados — como armazenamentos de séries temporais para métricas, índices de busca para logs e armazenamentos em grafo para rastreamento distribuído. Engenheiros que investigavam interrupções precisavam correlacionar manualmente as marcações de tempo entre essas plataformas distintas.
Nos últimos anos, o conceito de ontologias operacionais — representações formais de conhecimento que definem as entidades e relacionamentos dentro de um sistema — ganhou força como solução para a fragmentação da telemetria. Ao mapear dados MELT em uma estrutura de banco de dados em grafo, os sistemas podem manter uma topologia em tempo real de como serviços, servidores, bancos de dados e canais de rede interagem. O surgimento de grandes modelos de linguagem capazes de raciocínio, como o Claude da Anthropic, forneceu o componente operacional que faltava: agentes autônomos capazes de consultar estruturas de grafos usando linguagem natural e lógica de domínio estruturada, preenchendo efetivamente a lacuna entre a coleta de dados brutos e insights acionáveis.
## Reações Embora respostas públicas formais de fornecedores externos de tecnologia corporativa e provedores de nuvem permaneçam pendentes após a publicação inicial, a comunidade de engenharia de software tem acompanhado de perto os anúncios arquitetônicos da Netflix devido ao papel histórico da empresa como inovadora no código aberto.
Espera-se que especialistas do setor e engenheiros de confiabilidade de sites avaliem a viabilidade operacional de replicar a arquitetura de grafo de conhecimento da Netflix em ambientes com menor demanda de recursos. Um dos principais tópicos de discussão entre arquitetos de sistemas é a sobrecarga computacional e o custo financeiro associados à execução contínua de fluxos de trabalho agênticos baseados em grandes modelos de linguagem comerciais, juntamente com bancos de dados em grafo de alto rendimento, em um volume de 38 milhões de eventos por segundo.
Prevê-se que fornecedores de software de observabilidade — incluindo Datadog, Dynatrace, New Relic e Grafana Labs — enfrentem pressão de mercado para incorporar ontologias nativas baseadas em grafos e análise de incidentes com IA agêntica em suas plataformas comerciais de software como serviço (SaaS). Analistas do setor esperam que líderes de tecnologia corporativa busquem documentação técnica sobre como a Netflix gerencia a evolução do esquema do grafo, custos de consumo de tokens e restrições de latência ao integrar modelos de IA como o Claude diretamente em loops automatizados de resposta a incidentes de alta gravidade.
## O que ainda não sabemos Diversos detalhes técnicos críticos sobre a plataforma de observabilidade da Netflix permanecem não divulgados na declaração inicial de Vijayanathan e Sanchez-Silva: - Infraestrutura de Banco de Dados em Grafo: O mecanismo específico de banco de dados em grafo utilizado — seja uma solução proprietária interna, uma plataforma de código aberto como Neo4j ou JanusGraph, ou um serviço em nuvem gerenciado como o AWS Neptune — não foi especificado. - Mecânica de Integração do Modelo: Os detalhes arquitetônicos que regem como o Claude interage com o grafo de conhecimento — especificamente se a integração depende de APIs de modelo, pipelines dedicados de geração aumentada por recuperação (RAG) ou chamadas ajustadas de uso de ferramentas agênticas — não foram totalmente detalhados. - Sobrecarga Econômica e de Recursos: Os custos operacionais, a sobrecarga de latência e o consumo de recursos computacionais necessários para gerar e manter uma ontologia em tempo real a 38 milhões de eventos por segundo permanecem não quantificados. - Limites de Remediação Autônoma: Atualmente, não está claro se os fluxos de trabalho agênticos alimentados pelo Claude estão estritamente restritos ao diagnóstico de causa-raiz e notificação, ou se possuem permissão para executar ações automatizadas de remediação, como reiniciar microsserviços ou redirecionar o tráfego de rede.
O esclarecimento desses pontos em aberto será essencial para avaliar se este modelo guiado por ontologia pode ser adotado com custo-benefício viável por equipes de engenharia corporativas padrão.
## O que acompanhar Nos próximos meses, o monitoramento técnico, divulgações de código aberto e conferências do setor revelarão o impacto operacional mais amplo da mudança arquitetônica da Netflix: - Relatórios Técnicos (Whitepapers) e Lançamentos em Código Aberto: Observadores do setor acompanharão se a Netflix lançará atualizações detalhadas em blogs de engenharia, whitepapers revisados por pares ou repositórios de software de código aberto detalhando seus esquemas de ontologia operacional e padrões de integração de agentes do Claude. - Roteiros (Roadmaps) de Fornecedores de Observabilidade Corporativa: É provável que grandes fornecedores de monitoramento anunciem atualizações em seus roteiros de produtos, indicando se a integração MELT baseada em grafos e fluxos de trabalho agênticos de LLM se tornarão recursos comerciais padrão. - Apresentações em Conferências do Setor: Demonstrações e sessões técnicas conduzidas pela equipe de engenharia da Netflix em próximos eventos de engenharia de sistemas e nuvem — como AWS re:Invent, QCon ou SREcon — fornecerão métricas operacionais mais profundas sobre melhorias no MTTR e resultados de disponibilidade do sistema. - Benchmarks de Confiabilidade da Infraestrutura de IA: Reportagens adicionais acompanharão métricas de desempenho relativas à precisão dos fluxos de trabalho agênticos baseados no Claude durante grandes interrupções de nuvem no mundo real, oferecendo evidências empíricas da confiabilidade da IA na administração de sistemas em tempo real.
Este relato é baseado em informações técnicas divulgadas pelos engenheiros da Netflix Prasanna Vijayanathan e Renzo Sanchez-Silva.