Netflix presenta un grafo de conocimiento de telemetría impulsado por IA para gestionar 38 millones de eventos por segundo
Los ingenieros Prasanna Vijayanathan y Renzo Sanchez-Silva detallan el paso del monitoreo reactivo a flujos de trabajo agénticos impulsados por Claude a través de datos MELT unificados.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Netflix presenta un grafo de conocimiento de telemetría impulsado por IA para gestionar 38 millones de eventos por segundo
Los ingenieros Prasanna Vijayanathan y Renzo Sanchez-Silva detallan el paso del monitoreo reactivo a flujos de trabajo agénticos impulsados por Claude a través de datos MELT unificados.
Este artículo fue traducido automáticamente por la IA de nuestra redacción desde el original en inglés. Leer en inglés
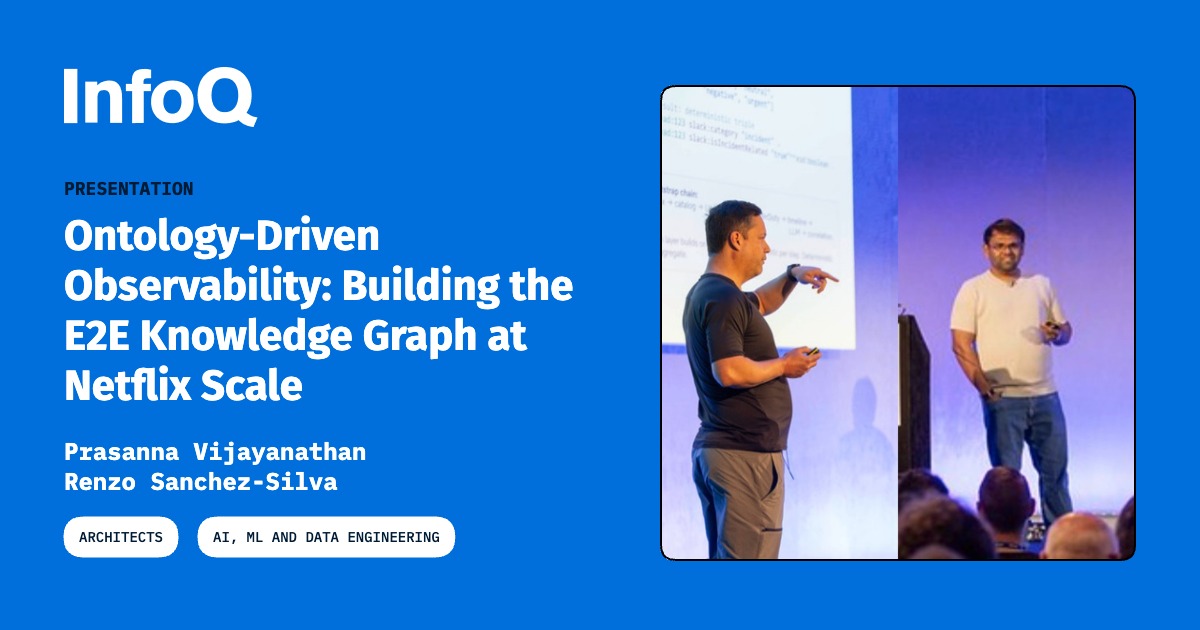
El 9 de octubre de 2026, los ingenieros de Netflix Prasanna Vijayanathan y Renzo Sanchez-Silva publicaron los detalles de una importante evolución arquitectónica en la infraestructura de telemetría del gigante del streaming, revelando cómo la plataforma gestiona el monitoreo en tiempo real a través de 38 millones de eventos por segundo. El comunicado técnico detalló la transición desde los marcos tradicionales de monitoreo reactivo hacia una ontología operativa impulsada por inteligencia artificial. Al unificar métricas, eventos, registros (logs) y trazas —conocidos colectivamente como telemetría MELT— en un grafo de conocimiento de extremo a extremo que se puede consultar, Netflix ha integrado flujos de trabajo de inteligencia artificial agéntica utilizando el modelo Claude de Anthropic junto con arquitecturas de bases de datos orientadas a grafos. El despliegue busca transformar la forma en que una de las operaciones nativas en la nube más grandes del mundo identifica dependencias del sistema, diagnostica causas raíz y gestiona complejos modos de falla en miles de microservicios.
## Key facts - Los ingenieros de Netflix Prasanna Vijayanathan y Renzo Sanchez-Silva presentaron la nueva arquitectura de observabilidad de la compañía el 9 de octubre de 2026. - La plataforma ingiere y procesa telemetría a un volumen de 38 millones de eventos por segundo en toda la infraestructura global de Netflix. - El sistema unifica cuatro pilares fundamentales de la telemetría —Métricas, Eventos, Registros (Logs) y Trazas (MELT)— en un único grafo de conocimiento consultable. - El modelo operativo transiciona a Netflix de un monitoreo reactivo a una ontología impulsada por IA que utiliza bases de datos de grafos y flujos de trabajo de IA agéntica basados en Claude. - La actualización arquitectónica tiene como objetivo un razonamiento contextual automatizado de extremo a extremo para aislar anomalías operativas en servicios distribuidos profundamente interconectados.
## What happened Según los detalles publicados por los ingenieros Prasanna Vijayanathan y Renzo Sanchez-Silva, Netflix ha completado un rediseño fundamental de su arquitectura de observabilidad empresarial, abordando la complejidad operativa de manejar 38 millones de eventos de telemetría por segundo. Históricamente, las plataformas masivas en la nube dependían de pilas de monitoreo fragmentadas donde las métricas, los registros de logs, las trazas de aplicaciones y los eventos discretos del sistema se almacenaban en silos de datos separados, lo que requería que los operadores humanos hicieran referencias cruzadas manuales en los paneles de control durante las interrupciones del servicio.
Bajo el nuevo paradigma detallado por Vijayanathan y Sanchez-Silva, Netflix consolidó estos flujos de telemetría dispares —Métricas, Eventos, Registros (Logs) y Trazas (MELT)— en una ontología operativa centralizada. Esta ontología modela las relaciones, dependencias y el flujo de datos en todo el ecosistema de microservicios de la plataforma. Al representar componentes de infraestructura, aplicaciones de software y flujos de red como nodos y aristas dentro de una base de datos de grafos especializada, el marco de trabajo crea un grafo de conocimiento vivo de extremo a extremo del entorno de ejecución de la plataforma.
Para poner en funcionamiento este grafo a gran escala, Netflix integró flujos de trabajo de inteligencia artificial agéntica utilizando el modelo de lenguaje Claude de Anthropic. En lugar de depender únicamente de alertas de umbral estático o consultas iniciadas por humanos, el sistema despliega agentes de IA que consultan de forma autónoma el grafo de conocimiento cuando ocurren anomalías. Estos agentes recorren las rutas de red, correlacionan identificadores de traza con picos de logs y desviaciones de métricas, y construyen explicaciones contextuales de las fallas del sistema. Según el comunicado técnico, este enfoque agéntico permite un análisis automatizado de causa raíz al permitir que los sistemas de IA mecanicen su razonamiento directamente sobre la topología estructural continua de la huella global de servicios de Netflix.
## Why it matters La transición hacia un grafo de observabilidad impulsado por ontologías representa un cambio estructural en cómo se mantienen los sistemas de software empresarial a gran escala, con implicaciones directas para los estándares de ingeniería en la nube, las prácticas de ingeniería de confiabilidad de sitios (SRE) y las estrategias corporativas de despliegue de IA.
A una escala de procesamiento de 38 millones de eventos por segundo, la respuesta a incidentes tradicional con supervisión humana directa (human-in-the-loop) enfrenta severas limitaciones físicas. En la arquitectura en la nube moderna, una sola solicitud de usuario puede desencadenar cientos de llamadas secundarias a través de microservicios responsables de la autenticación de usuarios, algoritmos de recomendación, codificación de video, metadatos del catálogo y redes de distribución de contenido (CDN). Cuando ocurre una falla, las tormentas de alertas a menudo inundan los centros de operaciones con miles de advertencias concurrentes, creando un problema de relación señal-ruido que retrasa el tiempo medio de resolución (MTTR).
Al reemplazar los conjuntos de reglas estáticas con un grafo de conocimiento MELT unificado y razonamiento de IA agéntica, Netflix aborda la latencia inherente del diagnóstico humano. La capacidad de un agente de IA, impulsado por modelos como Claude, para consultar programáticamente una base de datos de grafos en vivo significa que la asignación contextual de causas raíz puede ocurrir en segundos en lugar de horas. Para las organizaciones de software empresarial, esto demuestra una implementación concreta en producción de la IA generativa más allá de las interfaces de chatbot, demostrando la utilidad de los grandes modelos de lenguaje como motores de razonamiento operativo capaces de navegar topologías de sistemas complejos.
Además, este despliegue sienta un referente para la gestión de infraestructura en la nube. A medida que las empresas del sector financiero, la logística y las telecomunicaciones gestionan entornos de nube múltiple cada vez más complejos, es probable que la integración de ontologías de telemetría unificadas con agentes de IA autónomos se convierta en la arquitectura estándar para sistemas de alta disponibilidad.
## The background Para comprender la importancia de la actualización técnica de Netflix, es necesario examinar la evolución de la arquitectura nativa en la nube durante las últimas dos décadas. Netflix fue un pionero temprano en la migración a la nube, al trasladar toda su plataforma de streaming desde centros de datos privados a Amazon Web Services (AWS) entre 2008 y 2016. Durante esta migración, Netflix popularizó la arquitectura de microservicios, fragmentando el software monolítico en miles de servicios independientes y especializados que se comunican a través de API de red.
Si bien los microservicios brindaron una escalabilidad y velocidad de despliegue sin precedentes, generaron una complejidad operativa igualmente inaudita. En una aplicación monolítica tradicional, la depuración implica analizar una sola pila de llamadas y un archivo de registro localizado. En un ecosistema de microservicios, un pico de latencia transitorio en un clúster de base de datos puede repercutir en docenas de servicios dependientes, provocando fallas en cascada difíciles de rastrear hasta su origen.
Para gestionar esta complejidad, la industria del software desarrolló el marco de telemetría MELT: - Métricas: Representaciones numéricas de datos medidos a lo largo de intervalos de tiempo, como la utilización de CPU, el consumo de memoria o el recuento de solicitudes por segundo. - Eventos: Registros discretos e inmutables de acciones específicas que ocurren en un momento dado, como el despliegue de código, el reinicio de un servidor o el inicio de sesión de un usuario. - Registros (Logs): Salidas de texto detalladas emitidas por aplicaciones de software que contienen detalles contextuales con marcas de tiempo sobre la ejecución en tiempo de ejecución. - Trazas: Registros de extremo a extremo que siguen el ciclo de vida de una solicitud individual a medida que se desplaza a través de múltiples microservicios y límites de red.
A pesar de la adopción de los estándares MELT, la mayoría de los entornos empresariales mantenían estos cuatro tipos de datos en bases de datos aisladas, como almacenes de series temporales para métricas, índices de búsqueda para registros y almacenes de grafos para rastreo distribuido. Los ingenieros que investigaban interrupciones tenían que correlacionar manualmente las marcas de tiempo en estas distintas plataformas.
En los últimos años, el concepto de ontologías operativas —representaciones formales del conocimiento que definen las entidades y relaciones dentro de un sistema— ganó terreno como una solución a la fragmentación de la telemetría. Al mapear los datos MELT en una estructura de base de datos de grafos, los sistemas pueden mantener una topología en tiempo real de cómo interactúan los servicios, servidores, bases de datos y conductos de red. La aparición de modelos de lenguaje de gran tamaño con capacidad de razonamiento, como Claude de Anthropic, proporcionó el componente operativo que faltaba: agentes autónomos capaces de consultar estructuras de grafos utilizando lenguaje natural y lógica de dominio estructurada, cerrando eficazmente la brecha entre la recolección de datos brutos y la información útil para la toma de decisiones.
## Reaction Aunque las respuestas formales públicas por parte de proveedores externos de tecnología empresarial y proveedores de nube siguen pendientes tras la publicación inicial, la comunidad de ingeniería de software ha seguido de cerca los anuncios arquitectónicos de Netflix debido al papel histórico de la empresa como innovadora en código abierto.
Se espera que expertos de la industria e ingenieros de confiabilidad de sitios evalúen la viabilidad operativa de replicar la arquitectura de grafo de conocimiento de Netflix en entornos con menor consumo de recursos. Un tema principal de discusión entre los arquitectos de sistemas es la sobrecarga computacional y el costo financiero asociados con la ejecución de flujos de trabajo agénticos continuos impulsados por modelos de lenguaje comerciales junto con bases de datos de grafos de alto rendimiento a un volumen de 38 millones de eventos por segundo.
Se anticipa que los proveedores de software de observabilidad —incluidos Datadog, Dynatrace, New Relic y Grafana Labs— enfrenten presión de mercado para incorporar ontologías nativas basadas en grafos y análisis agéntico de incidentes por IA en sus plataformas comerciales de software como servicio (SaaS). Los analistas del sector prevén que los líderes tecnológicos empresariales busquen documentación técnica sobre cómo Netflix gestiona la evolución del esquema del grafo, los costos de consumo de tokens y las restricciones de latencia al integrar modelos de IA como Claude directamente en bucles de respuesta automatizada a incidentes de alta gravedad.
## What we don't know yet Varios detalles técnicos críticos sobre la plataforma de observabilidad de Netflix no han sido revelados en la divulgación inicial realizada por Vijayanathan y Sanchez-Silva: - Infraestructura de la base de datos de grafos: No se especificó el motor de base de datos de grafos concreto utilizado, ya fuera una solución propia desarrollada internamente, una plataforma de código abierto como Neo4j o JanusGraph, o un servicio gestionado en la nube como AWS Neptune. - Mecánica de integración del modelo: No se detallaron por completo los aspectos arquitectónicos que rigen cómo interactúa Claude con el grafo de conocimiento, específicamente si la integración depende de API de modelos, de canalizaciones dedicadas de generación aumentada por recuperación (RAG) o de llamadas optimizadas de uso de herramientas agénticas. - Sobrecarga económica y de recursos: Los costos operativos, la sobrecarga de latencia y el consumo de recursos de cómputo requeridos para generar y mantener una ontología en vivo a 38 millones de eventos por segundo permanecen sin cuantificar. - Límites de remediación autónoma: Actualmente no está claro si los flujos de trabajo agénticos impulsados por Claude están restringidos estrictamente al diagnóstico de causa raíz y notificación, o si cuentan con permisos para ejecutar acciones de remediación automatizadas, como reiniciar microservicios o reenrutar el tráfico de red.
Aclarar estos puntos abiertos será esencial para evaluar si este modelo impulsado por ontologías puede ser adoptado de manera rentable por los equipos de ingeniería empresarial estándar.
## What to watch En los próximos meses, el monitoreo técnico, las divulgaciones de código abierto y las conferencias de la industria revelarán el impacto operativo más amplio del cambio arquitectónico de Netflix: - Informes técnicos y publicaciones de código abierto: Los observadores del sector vigilarán si Netflix publica actualizaciones detalladas en sus blogs de ingeniería, informes técnicos revisados por pares o repositorios de software de código abierto que detallen los esquemas de su ontología operativa y los patrones de integración de los agentes de Claude. - Hojas de ruta de proveedores de observabilidad empresarial: Es probable que los principales proveedores de monitoreo anuncien actualizaciones en las hojas de ruta de sus productos, lo que indicará si la integración de MELT basada en grafos y los flujos de trabajo agénticos con LLM se convertirán en características comerciales estándar. - Presentaciones en conferencias del sector: Las demostraciones y sesiones técnicas a cargo del personal de ingeniería de Netflix en los próximos eventos de ingeniería de sistemas y nube —como AWS re:Invent, QCon o SREcon— proporcionarán métricas operativas más profundas sobre la mejora en el MTTR y los resultados de disponibilidad del sistema. - Evaluaciones comparativas de confiabilidad de la infraestructura de IA: Informes posteriores realizarán un seguimiento de las métricas de rendimiento relativas a la precisión de los flujos de trabajo agénticos basados en Claude durante grandes interrupciones reales de la nube, ofreciendo evidencia empírica de la confiabilidad de la IA en la administración de sistemas en tiempo real.
Este informe se basa en la información técnica publicada por los ingenieros de Netflix Prasanna Vijayanathan y Renzo Sanchez-Silva.