Netflix dévoile un graphe de connaissances télémétriques piloté par l'IA pour gérer 38 millions d'événements par seconde
Les ingénieurs Prasanna Vijayanathan et Renzo Sanchez-Silva détaillent le passage d'une surveillance réactive à des flux de travail agentiques propulsés par Claude sur des données MELT unifiées.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Netflix dévoile un graphe de connaissances télémétriques piloté par l'IA pour gérer 38 millions d'événements par seconde
Les ingénieurs Prasanna Vijayanathan et Renzo Sanchez-Silva détaillent le passage d'une surveillance réactive à des flux de travail agentiques propulsés par Claude sur des données MELT unifiées.
Cet article a été traduit automatiquement par l'IA de notre rédaction depuis l'original en anglais. Lire en anglais
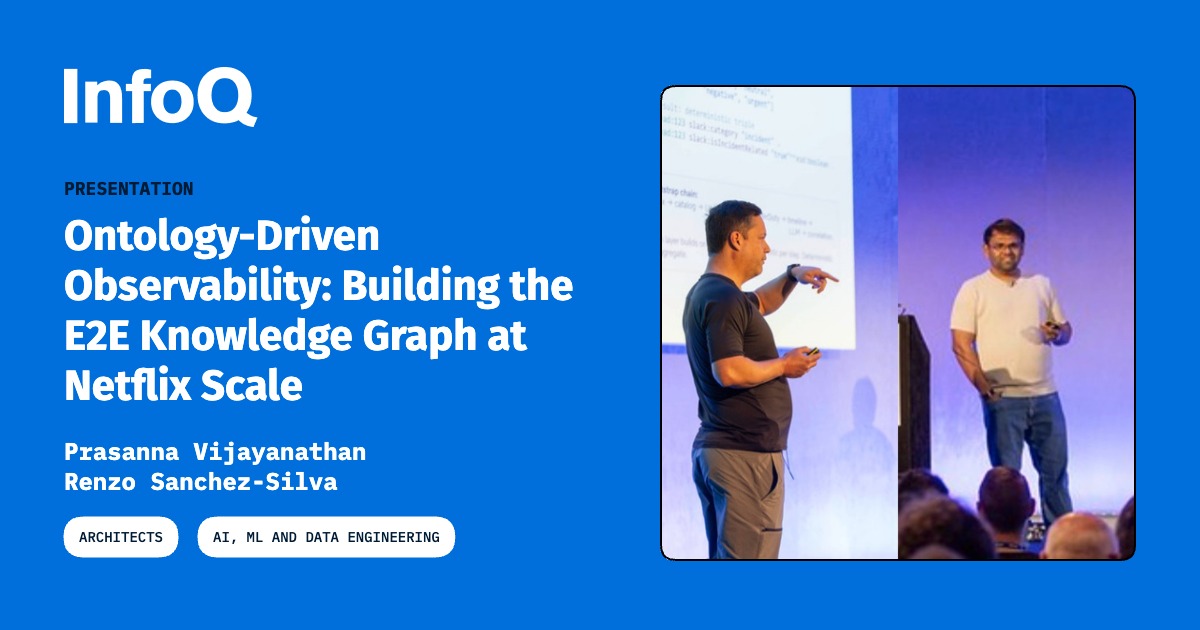
Le 9 octobre 2026, les ingénieurs de Netflix Prasanna Vijayanathan et Renzo Sanchez-Silva ont publié les détails d'une évolution architecturale majeure dans l'infrastructure télémétrique du géant du streaming, révélant comment la plate-forme gère le suivi en temps réel de 38 millions d'événements par seconde. La publication technique a esquissé l'abandon des cadres de surveillance réactifs traditionnels au profit d'une ontologie opérationnelle pilotée par l'IA. En unifiant métriques, événements, journaux et traces — collectivement appelés télémétrie MELT — au sein d'un graphe de connaissances de bout en bout interrogable, Netflix a intégré des flux de travail d'intelligence artificielle agentique s'appuyant sur le modèle Claude d'Anthropic aux côtés d'architectures de bases de données orientées graphe. Ce déploiement vise à transformer la manière dont l'une des plus grandes infrastructures cloud-natives au monde identifie les dépendances système, diagnostique les causes racines et gère les modes de défaillance complexes à travers des milliers de microservices.
## Faits marquants - Les ingénieurs de Netflix Prasanna Vijayanathan et Renzo Sanchez-Silva ont présenté la nouvelle architecture d'observabilité de l'entreprise le 9 octobre 2026. - La plate-forme ingère et traite la télémétrie à un volume de 38 millions d'événements par seconde sur l'ensemble de l'infrastructure mondiale de Netflix. - Le système unifie quatre piliers fondamentaux de la télémétrie — métriques, événements, journaux et traces (MELT) — au sein d'un graphe de connaissances interrogable unique. - Le modèle opérationnel fait passer Netflix d'une surveillance réactive à une ontologie pilotée par l'IA utilisant des bases de données orientées graphe et des flux de travail d'IA agentique propulsés par Claude. - La mise à jour architecturale vise un raisonnement contextuel automatisé de bout en bout pour isoler les anomalies opérationnelles au sein de services distribués profondément interconnectés.
## Ce qui s'est passé Selon les détails publiés par les ingénieurs Prasanna Vijayanathan et Renzo Sanchez-Silva, Netflix a achevé une refonte fondamentale de son architecture d'observabilité d'entreprise, répondant à la complexité opérationnelle liée au traitement de 38 millions d'événements télémétriques par seconde. Historiquement, les plates-formes cloud massives reposaient sur des empilements de surveillance fragmentés où les métriques, les enregistrements de journaux, les traces d'applications et les événements système distincts étaient stockés dans des silos de données séparés, obligeant les opérateurs humains à croiser manuellement les tableaux de bord lors des pannes opérationnelles.
Dans le cadre du nouveau paradigme détaillé par Vijayanathan et Sanchez-Silva, Netflix a consolidé ces flux télémétriques disparates — métriques, événements, journaux et traces (MELT) — au sein d'une ontologie opérationnelle centralisée. Cette ontologie modélise les relations, les dépendances et le flux de données à travers l'ensemble de l'écosystème de microservices de la plate-forme. En représentant les composants d'infrastructure, les applications logicielles et les flux réseau sous forme de nœuds et d'arêtes au sein d'une base de données orientée graphe spécialisée, le cadre crée un graphe de connaissances vivant de bout en bout de l'environnement d'exécution de la plate-forme.
Pour rendre ce graphe opérationnel à grande échelle, Netflix a intégré des flux de travail d'intelligence artificielle agentique en utilisant le modèle linguistique Claude d'Anthropic. Plutôt que de s'appuyer uniquement sur des alertes de seuil statiques ou des requêtes déclenchées par des humains, le système déploie des agents d'IA qui interrogent de manière autonome le graphe de connaissances lorsque des anomalies surviennent. Ces agents traversent les voies réseau, corrèlent les identifiants de trace avec les pics de journaux et les déviations de métriques, et construisent des explications contextuelles des défaillances du système. Selon la publication technique, cette approche agentique permet une analyse automatisée des causes racines en permettant aux systèmes d'IA de raisonner directement sur la topologie structurelle continue de l'empreinte globale de services de Netflix.
## Pourquoi c'est important La transition vers un graphe d'observabilité piloté par l'ontologie représente un changement structurel dans la manière dont les systèmes logiciels d'entreprise à grande échelle sont maintenus, avec des répercussions directes sur les normes d'ingénierie cloud, les pratiques d'ingénierie de fiabilité des sites (SRE) et les stratégies d'entreprise en matière de déploiement de l'IA.
À une échelle de traitement de 38 millions d'événements par seconde, la réponse aux incidents traditionnelle impliquant une intervention humaine se heurte à de sévères limites physiques. Dans l'architecture cloud moderne, une seule requête utilisateur peut déclencher des centaines d'appels en aval à travers des microservices responsables de l'authentification des utilisateurs, des algorithmes de recommandation, de l'encodage vidéo, des métadonnées du catalogue et des réseaux de diffusion de contenu. Lorsqu'une défaillance se produit, des tempêtes d'alertes inondent souvent les centres d'opérations de milliers d'avertissements simultanés, créant un problème de signal/bruit qui retarde le temps moyen de résolution (MTTR).
En remplaçant les ensembles de règles statiques par un graphe de connaissances MELT unifié et un raisonnement par IA agentique, Netflix répond à la latence inhérente au diagnostic humain. La capacité d'un agent d'IA, propulsé par des modèles tels que Claude, à interroger par programmation une base de données orientée graphe en direct signifie que la cartographie contextuelle de la cause racine peut s'effectuer en quelques secondes au lieu de plusieurs heures. Pour les organisations de logiciels d'entreprise, cela démontre une mise en œuvre concrète en production de l'IA générative au-delà des interfaces de chatbot, prouvant l'utilité des grands modèles linguistiques en tant que moteurs de raisonnement opérationnel capables de naviguer dans des topologies système complexes.
De plus, ce déploiement établit une référence pour la gestion de l'infrastructure cloud. Alors que les entreprises des secteurs des services financiers, de la logistique et des télécommunications gèrent des environnements multi-cloud de plus en plus complexes, l'intégration d'ontologies télémétriques unifiées avec des agents d'IA autonomes est susceptible de devenir l'architecture standard des systèmes à haute disponibilité.
## Le contexte Pour comprendre l'importance de la mise à jour technique de Netflix, il est nécessaire d'examiner l'évolution de l'architecture cloud-native au cours des deux dernières décennies. Netflix a été un pionnier de la migration vers le cloud, faisant passer l'ensemble de sa plate-forme de streaming de centres de données privés à Amazon Web Services (AWS) entre 2008 et 2016. Pendant cette migration, Netflix a popularisé l'architecture de microservices, décomposant les logiciels monolithiques en milliers de services indépendants et spécialisés communiquant via des API réseau.
Bien que les microservices aient offert une évolutivité et une rapidité de déploiement sans précédent, ils ont engendré une complexité opérationnelle inégalée. Dans une application monolithique traditionnelle, le débogage implique l'analyse d'une seule pile d'appels et d'un fichier journal localisé. Dans un écosystème de microservices, un pic de latence transitoire dans un cluster de bases de données peut se répercuter sur des dizaines de services dépendants, provoquant des défaillances en cascade difficiles à remonter jusqu'à leur origine.
Pour gérer cette complexité, l'industrie du logiciel a développé le cadre de télémétrie MELT : - Métriques : représentations numériques de données mesurées sur des intervalles de temps, telles que l'utilisation du processeur, la consommation de mémoire ou le nombre de requêtes par seconde. - Événements : enregistrements distincts et immuables d'actions spécifiques se produisant à un moment donné, comme le déploiement de code, le redémarrage d'un serveur ou la connexion d'un utilisateur. - Journaux : sorties textuelles détaillées émises par les applications logicielles contenant des détails contextuels horodatés concernant l'exécution du code. - Traces : enregistrements de bout en bout suivant le cycle de vie d'une requête individuelle lorsqu'elle traverse plusieurs microservices et frontières réseau.
Malgré l'adoption des normes MELT, la plupart des environnements d'entreprise conservaient ces quatre types de données dans des bases de données isolées — telles que des bases de séries temporelles pour les métriques, des index de recherche pour les journaux et des bases orientées graphe pour le traçage distribué. Les ingénieurs enquêtant sur les pannes devaient croiser manuellement les horodatages sur ces différentes plates-formes.
Ces dernières années, le concept d'ontologies opérationnelles — représentations formelles des connaissances définissant les entités et les relations au sein d'un système — a gagné en popularité comme solution à la fragmentation télémétrique. En cartographiant les données MELT dans une structure de base de données orientée graphe, les systèmes peuvent maintenir une topologie en temps réel de l'interaction entre les services, les serveurs, les bases de données et les canaux réseau. L'émergence de grands modèles linguistiques capables de raisonnement, tels que Claude d'Anthropic, a fourni le composant opérationnel manquant : des agents autonomes capables d'interroger des structures de graphe à l'aide du langage naturel et d'une logique de domaine structurée, comblant efficacement le fossé entre la collecte de données brutes et les informations exploitables.
## Réactions Bien que les réponses formelles publiques des fournisseurs de technologies d'entreprise externes et des fournisseurs de services cloud restent en attente après la publication initiale, la communauté de l'ingénierie logicielle a suivi de près les annonces architecturales de Netflix en raison du rôle historique de l'entreprise en tant qu'innovateur de l'open source.
Les experts du secteur et les ingénieurs en fiabilité de site devraient évaluer la faisabilité opérationnelle de la réplication de l'architecture de graphe de connaissances de Netflix dans des environnements moins gourmands en ressources. L'un des principaux sujets de discussion parmi les architectes système concerne la surcharge de calcul et le coût financier associés à l'exécution continue de flux de travail agentiques propulsés par des modèles linguistiques commerciaux à grande échelle aux côtés de bases de données orientées graphe à haut débit pour un volume de 38 millions d'événements par seconde.
Les éditeurs de logiciels d'observabilité — notamment Datadog, Dynatrace, New Relic et Grafana Labs — devaient faire face à la pression du marché pour intégrer des ontologies natives basées sur des graphes et l'analyse d'incidents par IA agentique dans leurs plates-formes commerciales de logiciel en tant que service (SaaS). Les analystes du secteur s'attendent à ce que les dirigeants des technologies d'entreprise recherchent de la documentation technique sur la manière dont Netflix gère l'évolution du schéma de graphe, les coûts de consommation de jetons et les contraintes de latence lors de l'intégration directe de modèles d'IA comme Claude dans les boucles de réponse automatisée aux incidents de haute sévérité.
## Ce que nous ne savons pas encore Plusieurs détails techniques critiques concernant la plate-forme d'observabilité de Netflix n'ont pas été divulgués dans la publication initiale de Vijayanathan et Sanchez-Silva : - Infrastructure de la base de données orientée graphe : le moteur de base de données orientée graphe spécifique utilisé — qu'il s'agisse d'une solution propriétaire interne, d'une plate-forme open source comme Neo4j ou JanusGraph, ou d'un service cloud géré comme AWS Neptune — n'a pas été précisé. - Mécanismes d'intégration des modèles : les détails architecturaux régissant la manière dont Claude interagit avec le graphe de connaissances — spécifiquement si l'intégration repose sur des API de modèles, des pipelines dédiés de génération augmentée par récupération (RAG) ou des appels d'outils agentiques optimisés — n'ont pas été entièrement détaillés. - Surcharge économique et en ressources : les coûts opérationnels, la surcharge de latence et la consommation de ressources informatiques requises pour générer et maintenir une ontologie en direct à 38 millions d'événements par seconde restent non quantifiés. - Limites de la remédiation autonome : il n'est actuellement pas clair si les flux de travail agentiques pilotés par Claude se limitent strictly au diagnostic de la cause racine et à la notification, ou s'ils disposent de la permission d'exécuter des actions de remédiation automatisées, telles que le redémarrage de microservices ou le réacheminement du trafic réseau.
La clarification de ces points ouverts sera essentielle pour évaluer si ce modèle piloté par l'ontologie peut être adopté de manière rentable par les équipes d'ingénierie d'entreprise standard.
## À surveiller Dans les mois à venir, la veille technique, les publications open source et les conférences du secteur révéleront l'impact opérationnel plus large du changement architectural de Netflix : - Livres blancs techniques et publications open source : les observateurs du secteur surveilleront si Netflix publie des mises à jour détaillées sur son blog d'ingénierie, des livres blancs évalués par des pairs ou des répertoires de logiciels open source détaillant ses schémas d'ontologies opérationnelles et les modèles d'intégration d'agents Claude. - Feuilles de route des éditeurs d'observabilité d'entreprise : les principaux éditeurs de logiciels de surveillance annonceront vraisemblablement des mises à jour de leurs feuilles de route produits, indiquant si l'intégration MELT basée sur des graphes et les flux de travail agentiques LLM deviendront des fonctionnalités commerciales standard. - Présentations lors de conférences du secteur : les démonstrations et les sessions techniques animées par le personnel d'ingénierie de Netflix lors d'événements à venir sur le cloud et l'ingénierie système — tels qu'AWS re:Invent, QCon ou SREcon — fourniront des métriques opérationnelles plus approfondies concernant l'amélioration du MTTR et les résultats de disponibilité du système. - Benchmarks de fiabilité des infrastructures d'IA : d'autres rapports suivront les métriques de performance concernant la précision des flux de travail agentiques propulsés par Claude lors de pannes cloud réelles majeures, offrant des preuves empiriques de la fiabilité de l'IA dans l'administration système en temps réel.
Ce rapport est basé sur des informations techniques publiées par les ingénieurs de Netflix Prasanna Vijayanathan et Renzo Sanchez-Silva.