

Полногеномный эксперимент с мутациями выявил ключевые ограничения ИИ при прогнозировании в вирусной биологии
Ведущие модели искусственного интеллекта не смогли точно спрогнозировать, как точечные мутации ДНК по всему геному вируса влияют на его биологические функции, что выявило ключевые ограничения геномного ИИ.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Полногеномный эксперимент с мутациями выявил ключевые ограничения ИИ при прогнозировании в вирусной биологии
Ведущие модели искусственного интеллекта не смогли точно спрогнозировать, как точечные мутации ДНК по всему геному вируса влияют на его биологические функции, что выявило ключевые ограничения геномного ИИ.
Эта статья переведена автоматически нашим редакционным ИИ с английского оригинала. Читать на английском
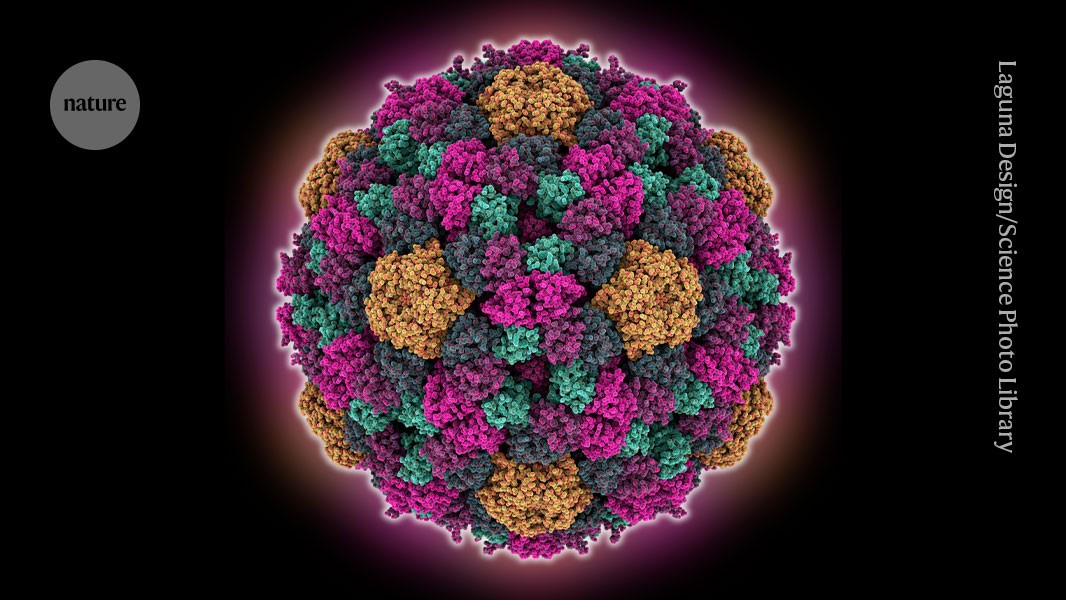
В рамках детального исследования в области современной вычислительной биологии ученые провели исчерпывающий лабораторный эксперимент, в ходе которого каждый отдельный нуклеотид вирусного генома подвергся систематическим мутациям для наблюдения за полученными биологическими эффектами. Целью инициативы была оценка возможностей передовых моделей искусственного интеллекта в сравнении с реальными эмпирическими данными. Согласно материалу, опубликованному Ewen Callaway 1 сентября 2026 года, исследование показало, что ведущие геномные ИИ-платформы не смогли точно спрогнозировать, как эти всеобъемлющие точечные модификации ДНК влияют на функциональную биологию вируса. Это открытие подчеркивает глубокие ограничения современных архитектур машинного обучения, демонстрируя, что, несмотря на недавний прогресс в автоматизированном анализе последовательностей, прогностическое ПО по-прежнему не способно надежно сопоставлять систематические генетические мутации с биологической жизнеспособностью.
## Key facts - Ученые провели полногеномный точечный мутагенез всей вирусной последовательности, чтобы зафиксировать биологические последствия каждой возможной замены одного нуклеотида. - Передовые модели искусственного интеллекта, разработанные для геномного анализа, не смогли надежно спрогнозировать фенотипические последствия этих систематических мутаций. - В ходе эксперимента был создан один из самых полных эмпирических наборов данных, связывающих вариации полногеномной последовательности напрямую с функциональными биологическими характеристиками. - Результаты сравнительного исследования были подробно описаны в научном репортаже, опубликованном Ewen Callaway 1 сентября 2026 года. - Полученные данные свидетельствуют о том, что современные ИИ-системы испытывают трудности с анализом сложных геномных особенностей, таких как некодирующие регуляторные области, эпистатические взаимодействия и общая приспособленность организма.
## What happened Чтобы проверить границы возможностей как генной инженерии, так и компьютерного прогнозирования, ученые провели систематическое мутационное сканирование всей нуклеотидной последовательности вируса. В геномике стандартное глубокое мутационное сканирование исторически фокусировалось на отдельных генах или конкретных белок-кодирующих участках. Однако в этом испытании исследователи масштабировали методологию, охватив каждую позицию во всем геноме вируса. В каждой генетической точке существующее нуклеотидное основание — аденин, цитозин, гуанин или тимин — систематически заменялось на все возможные альтернативные варианты, что позволило создать огромную библиотеку мутантных вариантов, представляющих каждую однонуклеотидную замену, возможную в полном генетическом коде организма.
После создания измененных вирусных вариантов в лаборатории исследователи оценили их функциональные свойства, измерив такие параметры, как скорость репликации вируса, клеточная инфекционность и общая биологическая приспособленность. Это позволило сформировать исчерпывающий эмпирический эталонный набор данных, точно детализирующий, какие точечные изменения были безвредными, какие меняли функциональные признаки, а какие оказались смертельными для вируса.
Параллельно исследователи оценили ведущие модели искусственного интеллекта, созданные для геномного прогнозирования. Эти алгоритмы, часто обучаемые на огромных репозиториях эволюционных последовательностей с использованием глубокого обучения и трансформерных архитектур, должны были спрогнозировать биологическое воздействие каждой конкретной мутации без предварительного доступа к новым экспериментальным измерениям. Когда вычислительные прогнозы сравнили с реальными лабораторными результатами, ИИ-модели продемонстрировали масштабную неточность, не сумев надежно отличить вредные, нейтральные или полезные мутации по всему вирусному геному.
## Why it matters Неспособность передовых ИИ-платформ точно отображать последствия полногеномных мутаций имеет прямые последствия для биотехнологии, синтетической биологии и разработки лекарственных препаратов. За последние несколько лет биологические языковые модели всё активнее интегрировались в рабочие процессы, направленные на проектирование новых синтетических белков, создание вирусных векторов для генной терапии, разработку мРНК-вакцин и прогнозирование того, как природные патогены могут мутировать, чтобы избегать иммунного ответа.
Эмпирические доказательства того, что современные модели оказываются неэффективными при оценке цельных вирусных геномов, показывают, что компьютерные прогнозы пока не могут заменить трудоемкую лабораторную валидацию. Слепое доверие инструментам машинного обучения при прогнозировании эволюции вирусов или проектировании функциональных синтетических конструкций создает значительные операционные риски, поскольку модели могут неверно рассчитать, какие генетические варианты остаются жизнеспособными или инфекционными. Для специалистов по биобезопасности и чиновников в сфере здравоохранения эти результаты свидетельствуют о том, что системам ИИ в настоящее время нельзя доверять автономную оценку уровня угрозы новых вирусных вариантов исключительно на основе данных последовательности.
Кроме того, результаты подчеркивают фундаментальный пробел в вычислительной биологии: распознавание паттернов последовательностей не эквивалентно пониманию функциональной биологии. Хотя биологические языковые модели отлично распознают эволюционную консервативность — отмечая, какие последовательности сохранились в ходе эволюции, — им трудно рассчитать физическую динамику генетических вариаций внутри компактных многофункциональных вирусных геномов, где перекрывающиеся рамки считывания и регуляторные элементы создают сложные слои биологической зависимости.
## The background Модели искусственного интеллекта, применяемые в геномике, быстро развивались в течение последнего десятилетия под сильным влиянием технологий обработки естественного языка. Крупные геномные языковые модели рассматривают последовательности ДНК, РНК или белков как текст, изучая статистические вероятности нуклеотидных или аминокислотных последовательностей на миллиардах биологических точек данных. Платформы, такие как DeepMind’s AlphaFold, трансформировали структурную биологию, прогнозируя трехмерные структуры белков на основе линейных аминокислотных последовательностей, что вдохновило на более широкие усилия по созданию моделей, способных предсказывать полные фенотипы организмов непосредственно из необработанных данных геномных последовательностей.
Исторически экспериментальная валидация генетических мутаций опиралась на глубокое мутационное сканирование — метод, внедренный в 2010-х годах для анализа того, как тысячи вариантов одного белка ведут себя под селективным давлением. Хотя глубокое мутационное сканирование давало карты высокого разрешения для отдельных белков, применение этой технологии ко всему геному сталкивалось с серьезными техническими препятствиями. Вирусные геномы, несмотря на значительно меньший размер по сравнению с бактериальными или эукариотическими, обладают уникальной структурной сложностью. Они часто упаковывают множество функций в крайне сжатые последовательности, используя перекрывающиеся гены, вторичные структуры РНК и регуляторные последовательности двойного назначения, где изменение одного нуклеотида может одновременно изменить несколько биологических путей.
Несмотря на распространение ИИ-моделей, обученных на огромных геномных базах данных, проверке их прогностической точности препятствовало отсутствие полных и непредвзятых наборов данных. Большинство существующих баз данных страдают от смещения выборки, фиксируя в основном мутации, сохранившиеся в процессе эволюционного отбора, или те, которые изучались в контексте конкретных заболеваний. Создав исчерпывающую лабораторную карту каждой точечной замены по всему вирусному геному, исследователи сформировали редкий, непредвзятый контрольный набор данных, на котором можно объективно протестировать вычислительные алгоритмы.
## Reaction Результаты вызвали широкую дискуссию среди специалистов по вычислительной биологии, биоинженеров и исследователей искусственного интеллекта. Многие эксперты в области машинного обучения для биологии признали, что исследование вскрывает устойчивые «слепые зоны» в том, как нейросети обрабатывают сложный биологический код. Хотя модели на основе последовательностей достигли впечатляющих результатов в определении эволюционной консервативности, исследователи отмечают, что нулевое (zero-shot) прогнозирование функциональных результатов для новых или сложных комбинаций мутаций остается нерешенной задачей.
В научных дискуссиях после публикации отчета исследователи подчеркивали, что работа должна послужить поводом для пересмотра ожиданий от ИИ в науках о жизни. Специалисты по синтетической биологии отметили, что результаты демонстрируют, почему реальное лабораторное тестирование остается незаменимым в процессах геномной инженерии. Тем временем разработчики систем машинного обучения рассматривают эти данные как призыв к пересмотру методологий обучения, утверждая, что будущие модели должны учитывать физические принципы, ограничения структурной биологии и прямые функциональные данные, а не опираться исключительно на сопоставление паттернов последовательностей.
## What we don't know yet Несколько критически важных вопросов остаются открытыми относительно точного масштаба сбоев ИИ и дальнейшего пути развития вычислительной биологии. В первоначальном отчете не был подробно перечислен каждый конкретный тип архитектуры ИИ-моделей, проходивших тестирование, что оставляет вопросы о том, показали ли определенные структуры нейросетей — например, трансформеры с длинным контекстом в сравнении с сверточными моделями или моделями пространств состояний — значительно лучшие или худшие результаты при оценке полногеномных вариаций.
Кроме того, остается неясным, как эти прогностические ограничения масштабируются на более крупные и сложные организмы. Геномы вирусов исключительно плотные и компактные, что может усиливать каскадные эффекты точечных мутаций по сравнению с более крупными бактериальными или человеческими геномами, содержащими обширные некодирующие последовательности. Исследователям еще предстоит выяснить, сможет ли предоставление моделям мультимодальных данных — например, объединение данных последовательности с трехмерными структурными моделями и прогнозами вторичной структуры РНК — сократить разрыв в эффективности, выявленный в этом полногеномном тесте точечных мутаций.
## What to watch В ближайшие месяцы несколько ключевых событий прояснят, как научное сообщество отреагирует на эти вычислительные ограничения. Исследователи будут следить за публичным выпуском полного мутационного набора данных, который, как ожидается, станет основным эталоном для обучения и оценки геномных ИИ-моделей следующего поколения по всему миру.
Наблюдателям также следует обратить внимание на обновления от ведущих научно-исследовательских институтов в области ИИ и биотехнологических компаний, которые дорабатывают свои алгоритмические архитектуры. Ключевым показателем прогресса станет то, смогут ли обновленные модели продемонстрировать более высокую эффективность на вторичных наборах данных для валидации без переобучения на новом вирусном эталоне. Кроме того, регуляторные органы и агентства здравоохранения, такие как U.S. Food and Drug Administration и международные комиссии по биобезопасности, вероятно, изучат эти результаты при разработке стандартов аудита ИИ-инструментов, используемых в синтетической биологии, разработке лекарств и оценке вирусных рисков.
Материал подготовлен на основе новостного репортажа, опубликованного Ewen Callaway 1 сентября 2026 года.
Источник: Callaway; Ewen

