

Une expérience de mutation à l'échelle du génome révèle les limites prédictives majeures de l'IA en biologie virale
De grands modèles d'intelligence artificielle n'ont pas réussi à prédire avec précision l'impact de mutations de l'ADN d'une seule lettre sur l'ensemble d'un génome viral, révélant des limites clés de l'IA génomique.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Une expérience de mutation à l'échelle du génome révèle les limites prédictives majeures de l'IA en biologie virale
De grands modèles d'intelligence artificielle n'ont pas réussi à prédire avec précision l'impact de mutations de l'ADN d'une seule lettre sur l'ensemble d'un génome viral, révélant des limites clés de l'IA génomique.
Cet article a été traduit automatiquement par l'IA de notre rédaction depuis l'original en anglais. Lire en anglais
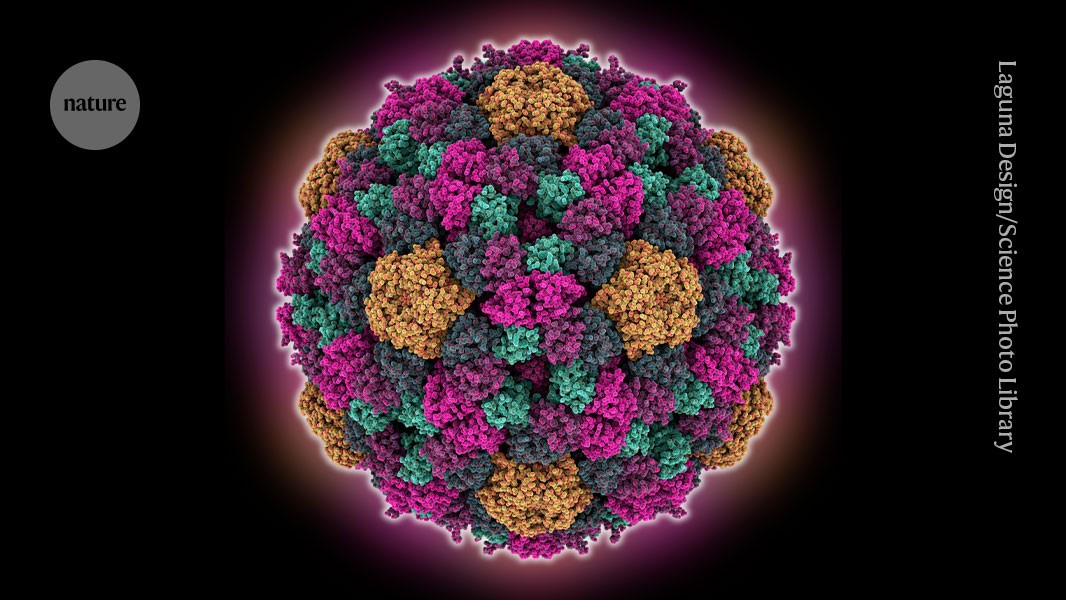
Dans le cadre d'un examen rigoureux de la biologie computationnelle moderne, des chercheurs ont réalisé une expérience en laboratoire exhaustive au cours de laquelle chaque lettre nucléotidique individuelle d'un génome viral a été systématiquement mutée pour observer les effets biologiques résultants. L'initiative visait à évaluer les capacités des modèles d'intelligence artificielle de pointe par rapport à des données empiriques du monde réel. Selon un reportage publié par Ewen Callaway le 1er sept. 2026, l'enquête a révélé que les meilleures plateformes d'IA génomique n'ont pas réussi à prédire avec précision la manière dont ces modifications complètes de l'ADN d'une seule lettre affectaient la biologie fonctionnelle du virus. Cette constatation met en évidence de profondes limites dans les architectures actuelles d'apprentissage automatique, montrant que malgré les récents progrès dans l'analyse automatisée des séquences, les logiciels prédictifs restent incapables de cartographier de manière fiable la manière dont les mutations génétiques systématiques se traduisent en viabilité biologique.
## Faits marquants - Des scientifiques ont effectué une mutagenèse d'une seule lettre à l'échelle du génome complet sur toute une séquence virale afin de documenter les conséquences biologiques de chaque substitution de nucléotide possible. - Les modèles d'intelligence artificielle de pointe conçus pour l'analyse génomique n'ont pas réussi à prévoir de manière fiable les résultats phénotypiques de ces mutations systématiques. - L'expérience a permis d'établir l'un des jeux de données empiriques les plus complets reliant directement la variation de la séquence du génome entier aux performances biologiques fonctionnelles. - Les résultats de l'étude comparative ont été détaillés dans un article scientifique publié par Ewen Callaway le 1er sept. 2026. - Les conclusions démontrent que les systèmes d'IA actuels peinent avec les caractéristiques génomiques complexes telles que les régions régulatrices non codantes, les interactions épistatiques et l'aptitude biologique globale de l'organisme.
## Que s'est-il passé Pour tester les limites de l'ingénierie génétique et de la prédiction computationnelle, des scientifiques ont procédé à un balayage mutationnel systématique de l'ensemble de la séquence nucléotidique d'un virus. En science génomique, le balayage mutationnel profond classique s'est historiquement concentré sur des gènes isolés ou des régions spécifiques codant des protéines. Dans cet essai, cependant, les chercheurs ont élargi la méthodologie pour couvrir chaque position de l'ensemble du génome du virus. À chaque emplacement génétique, la base nucléotidique existante — adénine, cytosine, guanine ou thymine — a été systématiquement remplacée par toutes les autres options, générant une vaste bibliothèque de variants mutants représentant chaque substitution de nucléotide unique possible dans le patrimoine génétique complet de l'organisme.
Une fois ces variants viraux modifiés générés en laboratoire, les chercheurs ont évalué leurs propriétés fonctionnelles, en mesurant des paramètres tels que les taux de réplication virale, l'infectiosité cellulaire et la viabilité biologique globale. Cela a permis de créer un jeu de données empirique de référence exhaustif détaillant exactement quelles modifications d'une seule lettre étaient bénignes, lesquelles altéraient des traits fonctionnels et lesquelles s'avéraient létales pour le virus.
En parallèle, les chercheurs ont évalué de grands modèles d'intelligence artificielle conçus pour la prédiction génomique. Ces algorithmes, souvent entraînés sur de vastes répertoires de séquences évolutives à l'aide du deep learning et d'architectures basées sur les transformers, avaient pour mission de prédire l'impact biologique de chaque mutation spécifique sans accès préalable aux nouvelles mesures expérimentales. Lorsque les prédictions computationnelles ont été comparées aux résultats physiques obtenus en laboratoire, les modèles d'IA ont fait preuve d'une inexactitude généralisée, échouant à distinguer de manière fiable les mutations nocives, neutres ou bénéfiques sur l'ensemble du génome viral.
## Pourquoi c'est important L'échec des plateformes d'IA avancées à cartographier avec précision les impacts mutationnels à l'échelle du génome entier comporte des conséquences immédiates pour la biotechnologie, la biologie synthétique et le développement thérapeutique. Au cours des dernières années, les modèles linguistiques biologiques ont été de plus en plus intégrés dans les flux de travail visant à concevoir de nouvelles protéines synthétiques, à mettre au point des vecteurs viraux pour la thérapie génique, à développer des vaccins à ARN messager et à prédire comment les agents pathogènes naturels pourraient muter pour échapper à l'immunité.
La preuve empirique que les modèles actuels sont insuffisants pour évaluer des génomes viraux complets indique que les prédictions computationnelles ne peuvent pas encore remplacer la validation laborieuse en laboratoire. Se fier aveuglément aux outils d'apprentissage automatique pour prédire l'évolution virale ou concevoir des constructions synthétiques fonctionnelles engendre des risques opérationnels significatifs, car les modèles peuvent mal calculer quels variants génétiques restent viables ou infectieux. Pour les spécialistes de la biosécurité et les responsables de la santé publique, ces conclusions indiquent qu'on ne peut pas faire confiance aux systèmes d'IA actuels pour évaluer de manière autonome le niveau de menace des variants viraux émergents en se basant uniquement sur des données de séquence.
De plus, les résultats soulignent une lacune fondamentale en biologie computationnelle : la reconnaissance de motifs dans les séquences n'est pas équivalente à une compréhension biologique fonctionnelle. Bien que les modèles linguistiques biologiques excellent dans la reconnaissance de la conservation évolutive — en identifiant les séquences qui ont été préservées au fil de l'histoire —, ils peinent à calculer la dynamique physique de la variation génétique au sein de génomes viraux condensés et multifonctionnels, où les cadres de lecture chevauchants et les éléments régulateurs créent des niveaux complexes de dépendance biologique.
## Contexte Les modèles d'intelligence artificielle appliqués à la génomique se sont développés rapidement au cours de la dernière décennie, fortement influencés par les technologies du traitement automatique du langage naturel. Les grands modèles linguistiques génomiques fonctionnent en traitant les séquences d'ADN, d'ARN ou de protéines comme du texte, apprenant les probabilités statistiques des séquences de nucléotides ou d'acides aminés à partir de milliards de données biologiques. Des plateformes telles qu'AlphaFold de DeepMind ont transformé la biologie structurale en prédisant les structures tridimensionnelles des protéines à partir de séquences linéaires d'acides aminés, inspirant des efforts plus larges pour construire des modèles capables de prédire des phénotypes d'organismes complets directement à partir de données brutes de séquences génomiques.
Historiquement, la validation expérimentale des mutations génétiques reposait sur le balayage mutationnel profond, une technique introduite dans les années 2010 pour analyser les performances de milliers de variants d'une seule protéine sous pression sélective. Bien que le balayage mutationnel profond ait permis d'obtenir des cartes à haute résolution pour des protéines individuelles, l'application de cette technique à l'échelle d'un génome entier a présenté d'immenses obstacles techniques. Les génomes viraux, bien qu'étant nettement plus petits que les génomes bactériens ou eucaryotes, présentent des complexités structurales uniques. Ils regroupent fréquemment de multiples fonctions dans des séquences très condensées, utilisant des gènes chevauchants, des structures secondaires d'ARN et des séquences régulatrices à double usage où un seul changement de nucléotide peut altérer simultanément plusieurs voies biologiques.
Malgré la prolifération de modèles d'IA entraînés sur de vastes bases de données génomiques, la validation de leur précision prédictive a été entravée par le manque de jeux de données complets et non biaisés. La plupart des bases de données existantes souffrent d'un biais d'évaluation, enregistrant principalement les mutations qui ont survécu à la sélection évolutive ou celles étudiées dans des contextes de maladies spécifiques. En générant une carte de laboratoire exhaustive de chaque changement d'une seule lettre sur un génome viral complet, les chercheurs ont créé un jeu de données de contrôle rare et non biaisé par rapport auquel les algorithmes computationnels ont pu être testés objectivement.
## Réactions Ces résultats ont suscité de vastes discussions parmi les biologistes computationnels, les bio-ingénieurs et les chercheurs en intelligence artificielle. De nombreux experts du domaine de l'apprentissage automatique appliqué à la biologie ont reconnu que l'étude révèle des angles morts persistants dans la manière dont les réseaux de neurones traitent le code biologique complexe. Bien que les modèles basés sur les séquences aient atteint des performances impressionnantes pour identifier la conservation évolutive, les chercheurs soulignent que la prédiction à zéro coup (« zero-shot ») des résultats fonctionnels à partir de combinaisons de mutations nouvelles ou complexes reste un défi non résolu.
Dans les discussions scientifiques ayant suivi le rapport, les chercheurs ont souligné que l'étude devrait servir de recalibrage des attentes entourant l'IA dans les sciences de la vie. Les spécialistes en biologie synthétique ont noté que les résultats démontrent pourquoi les tests physiques en laboratoire restent indispensables dans les flux de travail de l'ingénierie génomique. Pendant ce temps, les développeurs d'apprentissage automatique considèrent ces conclusions comme une incitation à restructurer les méthodologies d'entraînement, soutenant que les futurs modèles devront intégrer des principes physiques, des contraintes de biologie structurale et des données fonctionnelles directes plutôt que de s'appuyer exclusivement sur la reconnaissance de motifs basée sur les séquences.
## Ce que nous ne savons pas encore Plusieurs questions critiques restent ouvertes concernant la portée exacte des échecs de l'IA et la voie à suivre pour la biologie computationnelle. Le rapport initial n'a pas détaillé avec précision chaque architecture spécifique de modèle d'IA évaluée dans le cadre de cette étude comparative, laissant sans réponse la question de savoir si certaines conceptions de réseaux de neurones — telles que les transformers à long contexte par rapport aux modèles convolutionnels ou d'espace d'état — ont obtenu des résultats nettement meilleurs ou moins bons que d'autres lors de l'évaluation des variations à l'échelle du génome entier.
De plus, on ne sait pas encore dans quelle mesure ces limites prédictives s'étendent à des organismes plus grands et plus complexes. Les génomes viraux sont particulièrement denses et compacts, ce qui peut amplifier les effets en cascade des mutations d'une seule lettre par rapport à des génomes bactériens ou humains plus vastes contenant d'importantes séquences non codantes. Les chercheurs n'ont pas encore déterminé si le fait de fournir aux modèles des entrées multimodales — comme la combinaison de données de séquence avec des modèles structuraux tridimensionnels et des prédictions de structure secondaire d'ARN — peut combler l'écart de performance observé dans cette évaluation comparative d'une seule lettre à l'échelle du génome entier.
## À surveiller Au cours des prochains mois, plusieurs étapes clés préciseront la manière dont la communauté scientifique répond à ces limites computationnelles. Les chercheurs surveilleront la publication complète du jeu de données mutationnel, qui devrait devenir une référence majeure pour l'entraînement et l'évaluation des modèles d'IA génomique de prochaine génération dans le monde entier.
Les observateurs devront également suivre les mises à jour des principales institutions de recherche en IA et des entreprises de biotechnologie à mesure qu'elles affinent leurs architectures algorithmiques. Un indicateur clé de progrès sera la capacité des modèles mis à jour à démontrer des performances améliorées sur des jeux de données de validation secondaires sans surapprentissage (« overfitting ») par rapport au nouveau benchmark viral. En outre, les organismes de réglementation et les agences de santé publique, tels que la U.S. Food and Drug Administration et les groupes internationaux de biosécurité, examineront vraisemblablement ces conclusions lors de l'établissement de normes d'audit pour les outils d'IA utilisés en biologie synthétique, en découverte de médicaments et en évaluation des risques viraux.
Les informations de cet article sont basées sur un reportage publié par Ewen Callaway le 1er sept. 2026.
Source : Callaway; Ewen

