

Un experimento de mutación en todo el genoma expone grandes limitaciones predictivas de la IA en biología viral
Los principales modelos de inteligencia artificial no lograron predecir con exactitud cómo afectan a la función biológica las mutaciones de una sola letra de ADN en todo un genoma viral, lo que expone limitaciones clave en la IA genómica.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Un experimento de mutación en todo el genoma expone grandes limitaciones predictivas de la IA en biología viral
Los principales modelos de inteligencia artificial no lograron predecir con exactitud cómo afectan a la función biológica las mutaciones de una sola letra de ADN en todo un genoma viral, lo que expone limitaciones clave en la IA genómica.
Este artículo fue traducido automáticamente por la IA de nuestra redacción desde el original en inglés. Leer en inglés
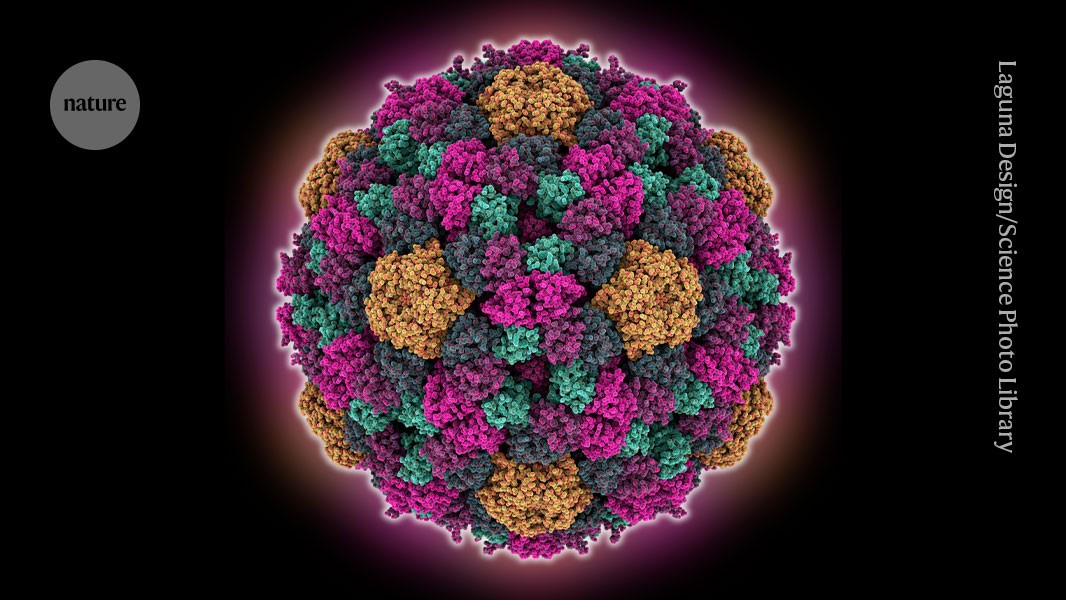
En un riguroso examen de la biología computacional moderna, un grupo de investigadores completó un exhaustivo experimento de laboratorio en el que cada letra de nucleótido individual de un genoma viral fue mutada sistemáticamente para observar los efectos biológicos resultantes. La iniciativa se propuso evaluar las capacidades de los modelos de inteligencia artificial de última generación en comparación con datos empíricos del mundo real. Según un informe publicado por Ewen Callaway el 1 de septiembre de 2026, la investigación reveló que las principales plataformas genómicas de IA no lograron predecir con exactitud cómo afectaban estas modificaciones integrales de ADN de una sola letra a la biología funcional del virus. El hallazgo pone de manifiesto profundas limitaciones en las arquitecturas actuales de aprendizaje automático, lo que demuestra que, a pesar de los recientes avances en el análisis automatizado de secuencias, el software predictivo sigue siendo incapaz de trazar con fiabilidad cómo las mutaciones genéticas sistemáticas se traducen en viabilidad biológica.
## Datos clave - Científicos realizaron una mutagénesis de una sola letra en todo el genoma a lo largo de una secuencia viral completa para documentar las consecuencias biológicas de cada intercambio posible de un solo nucleótido. - Los modelos de inteligencia artificial de última generación diseñados para el análisis genómico no consiguieron predecir con fiabilidad los resultados fenotípicos de estas mutaciones sistemáticas. - El experimento estableció uno de los conjuntos de datos empíricos más exhaustivos que conectan la variación de la secuencia del genoma completo directamente con el rendimiento biológico funcional. - Los resultados del estudio de evaluación comparativa se detallaron en un informe científico publicado por Ewen Callaway el 1 de septiembre de 2026. - Los hallazgos demuestran que los sistemas de IA actuales tienen dificultades con características genómicas complejas, como las regiones reguladoras no codificantes, las interacciones epistáticas y la aptitud biológica general del organismo.
## Qué ocurrió Para probar los límites tanto de la ingeniería genética como de la predicción computacional, los científicos llevaron a cabo un escaneo mutacional sistemático a lo largo de toda la secuencia de nucleótidos de un virus. En la ciencia genómica, el escaneo mutacional profundo estándar se ha centrado históricamente en genes aislados o regiones específicas codificantes de proteínas. Sin embargo, en este ensayo, los investigadores ampliaron la metodología para cubrir cada posición en todo el genoma del virus. En cada ubicación genética, la base de nucleótidos existente (adenina, citosina, guanina o timina) se intercambió sistemáticamente por cada opción alternativa, lo que generó una biblioteca masiva de variantes mutantes que representaba cada sustitución de un solo nucleótido posible dentro del mapa genético completo del organismo.
Una vez generadas estas variantes virales alteradas en el laboratorio, los investigadores evaluaron sus propiedades funcionales, midiendo parámetros como las tasas de replicación viral, la infectividad celular y la aptitud biológica general. Esto creó un conjunto de datos empíricos de referencia exhaustivo que detallaba exactamente qué cambios de una sola letra eran benignos, cuáles alteraban los rasgos funcionales y cuáles resultaban letales para el virus.
De manera simultánea, los investigadores evaluaron los principales modelos de inteligencia artificial creados para la predicción genómica. Estos algoritmos, a menudo entrenados en vastos repositorios de secuencias evolutivas mediante aprendizaje profundo y arquitecturas basadas en transformers, tuvieron la tarea de predecir el impacto biológico de cada mutación específica sin acceso previo a las nuevas mediciones experimentales. Cuando las predicciones computacionales se compararon con los resultados físicos de laboratorio, los modelos de IA demostraron una imprecisión generalizada, al no lograr distinguir con fiabilidad entre mutaciones perjudiciales, neutras o beneficiosas a lo largo del genoma viral.
## Por qué es importante El fracaso de las plataformas avanzadas de IA a la hora de mapear con exactitud los impactos mutacionales en todo el genoma conlleva consecuencias inmediatas para la biotecnología, la biología sintética y el desarrollo terapéutico. En los últimos años, los modelos de lenguaje biológico se han integrado cada vez más en los flujos de trabajo orientados a diseñar nuevas proteínas sintéticas, diseñar vectores virales para terapia génica, desarrollar vacunas de ARNm y predecir cómo podrían mutar los patógenos naturales para escapar a la inmunidad.
La evidencia empírica de que los modelos actuales se quedan cortos al evaluar genomas virales completos indica que las predicciones computacionales aún no pueden sustituir a la validación de laboratorio, que requiere un uso intensivo de mano de obra. Confiar ciegamente en las herramientas de aprendizaje automático para predecir la evolución viral o diseñar construcciones sintéticas funcionales crea riesgos operativos significativos, ya que los modelos pueden calcular mal qué variantes genéticas siguen siendo viables o infecciosas. Para los especialistas en bioseguridad y los funcionarios de salud pública, los hallazgos indican que actualmente no se puede confiar en que los sistemas de IA evalúen de forma autónoma el nivel de amenaza de las variantes virales emergentes basándose únicamente en datos de secuencias.
Además, los resultados ponen de relieve una brecha fundamental en la biología computacional: el reconocimiento de patrones de secuencias no equivale a la comprensión biológica funcional. Aunque los modelos de lenguaje biológico sobresalen en el reconocimiento de la conservación evolutiva —señalando qué secuencias se han conservado a lo largo de la historia—, tienen dificultades para calcular la dinámica física de la variación genética dentro de genomas virales condensados y multifuncionales, donde los marcos de lectura superpuestos y los elementos reguladores crean intrincadas capas de dependencia biológica.
## Antecedentes Los modelos de inteligencia artificial aplicados a la genómica se han expandido rápidamente durante la última década, muy influenciados por las tecnologías de procesamiento del lenguaje natural. Los grandes modelos de lenguaje genómico funcionan tratando las secuencias de ADN, ARN o proteínas como texto, aprendiendo las probabilidades estadísticas de las secuencias de nucleótidos o aminoácidos a través de miles de millones de puntos de datos biológicos. Plataformas como AlphaFold de DeepMind transformaron la biología estructural al predecir estructuras de proteínas tridimensionales a partir de secuencias lineales de aminoácidos, lo que inspiró esfuerzos más amplios para construir modelos capaces de predecir fenotipos de organismos completos directamente a partir de datos de secuencias genómicas brutas.
Históricamente, la validación experimental de las mutaciones genéticas dependía del escaneo mutacional profundo, una técnica introducida en la década de 2010 para analizar cómo se comportan miles de variantes de una sola proteína bajo presión selectiva. Si bien el escaneo mutacional profundo ofreció mapas de alta resolución para proteínas individuales, aplicar la técnica a todo un genoma planteaba obstáculos técnicos considerables. Los genomas virales, a pesar de ser significativamente más pequeños que los genomas bacterianos o eucariotas, presentan complejidades estructurales únicas. Con frecuencia empaquetan múltiples funciones en secuencias altamente comprimidas, utilizando genes superpuestos, estructuras secundarias de ARN y secuencias reguladoras de doble propósito donde un solo cambio de nucleótido puede alterar simultáneamente múltiples vías biológicas.
A pesar de la proliferación de modelos de IA entrenados en vastas bases de datos genómicas, la validación de su precisión predictiva se ha visto dificultada por la falta de conjuntos de datos completos y no sesgados. La mayoría de las bases de datos existentes sufren de sesgo de determinación, al registrar principalmente mutaciones que han sobrevivido a la selección evolutiva o aquellas estudiadas en contextos de enfermedades específicas. Al generar un mapa de laboratorio exhaustivo de cada cambio de una sola letra en todo un genoma viral, los investigadores crearon un conjunto de datos de control no sesgado y poco común contra el cual se pudieron probar objetivamente los algoritmos computacionales.
## Reacciones Los hallazgos han provocado un amplio debate entre biólogos computacionales, bioingenieros e investigadores de inteligencia artificial. Muchos expertos en el campo del aprendizaje automático aplicado a la biología han reconocido que el estudio expone puntos ciegos persistentes sobre cómo las redes neuronales procesan el código biológico complejo. Si bien los modelos basados en secuencias han logrado hitos impresionantes en la identificación de la conservación evolutiva, los investigadores señalan que predecir resultados funcionales de tipo zero-shot a partir de combinaciones de mutaciones nuevas o complejas sigue siendo un desafío no resuelto.
En los debates científicos posteriores al informe, los investigadores enfatizaron que el estudio debería servir para recalibrar las expectativas en torno a la IA en las ciencias de la vida. Los biólogos sintéticos han señalado que los resultados demuestran por qué las pruebas físicas de laboratorio siguen siendo indispensables en los flujos de trabajo de ingeniería genómica. Mientras tanto, los desarrolladores de aprendizaje automático han señalado los hallazgos como un mandato para reestructurar las metodologías de entrenamiento, argumentando que los futuros modelos deben incorporar principios físicos, restricciones de biología estructural y datos funcionales directos en lugar de depender exclusivamente del reconocimiento de patrones basado en secuencias.
## Lo que aún no se sabe Siguen abiertas varias preguntas fundamentales sobre el alcance exacto de los fallos de la IA y el camino a seguir para la biología computacional. El informe inicial no detalló por completo cada arquitectura específica de modelo de IA evaluada en la prueba comparativa, lo que deja dudas sobre si ciertos diseños de redes neuronales —como los transformers de contexto largo frente a los modelos convolucionales o de espacio de estados— funcionaron significativamente mejor o peor que otros al evaluar variaciones en todo el genoma.
Además, aún no está claro cómo se trasladan estas limitaciones predictivas a organismos más grandes y complejos. Los genomas virales son excepcionalmente densos y compactos, lo que puede amplificar los efectos en cascada de las mutaciones de una sola letra en comparación con genomas bacterianos o humanos más grandes que contienen extensas secuencias no codificantes. Los investigadores aún tienen que establecer si el hecho de proporcionar a los modelos entradas multimodales —como combinar datos de secuencias con modelos estructurales tridimensionales y predicciones de estructura secundaria de ARN— puede reducir la brecha de rendimiento observada en esta prueba comparativa de genoma completo y una sola letra.
## A qué prestar atención En los próximos meses, varios hitos clave aclararán cómo responde la comunidad científica a estas limitaciones computacionales. Los investigadores estarán atentos a la publicación abierta del conjunto de datos mutacionales completo, que se espera se convierta en una referencia principal para entrenar y evaluar modelos de IA genómica de próxima generación en todo el mundo.
Los observadores también deberían estar atentos a las actualizaciones de las principales instituciones de investigación en IA y empresas de biotecnología a medida que perfeccionan sus arquitecturas algorítmicas. Un indicador clave del progreso será si los modelos actualizados pueden demostrar un mejor rendimiento en conjuntos de datos de validación secundarios sin sobreajustarse al nuevo punto de referencia viral. Asimismo, es probable que los organismos reguladores y las agencias de salud pública, como la U.S. Food and Drug Administration y los paneles internacionales de bioseguridad, revisen estos hallazgos a medida que establezcan normas para auditar las herramientas de IA utilizadas en biología sintética, descubrimiento de fármacos y evaluación de riesgos virales.
La información de este artículo se basa en la cobertura periodística publicada por Ewen Callaway el 1 de septiembre de 2026.
Fuente: Callaway; Ewen

