Diogo Almeida, l'un des premiers développeurs de ChatGPT, remet en cause la trajectoire de l'IA et soutient un concurrent à bas coût
Un ingénieur clé à l'origine de ChatGPT d'OpenAI affirme que le modèle phare n'a pas tenu ses promesses et plaide pour un rival de l'IA à bas coût, selon de nouvelles informations.
The Global Wire Newsroom ·
Link preview · horizonglobalnews.com
Diogo Almeida, l'un des premiers développeurs de ChatGPT, remet en cause la trajectoire de l'IA et soutient un concurrent à bas coût
Un ingénieur clé à l'origine de ChatGPT d'OpenAI affirme que le modèle phare n'a pas tenu ses promesses et plaide pour un rival de l'IA à bas coût, selon de nouvelles informations.
Cet article a été traduit automatiquement par l'IA de notre rédaction depuis l'original en anglais. Lire en anglais
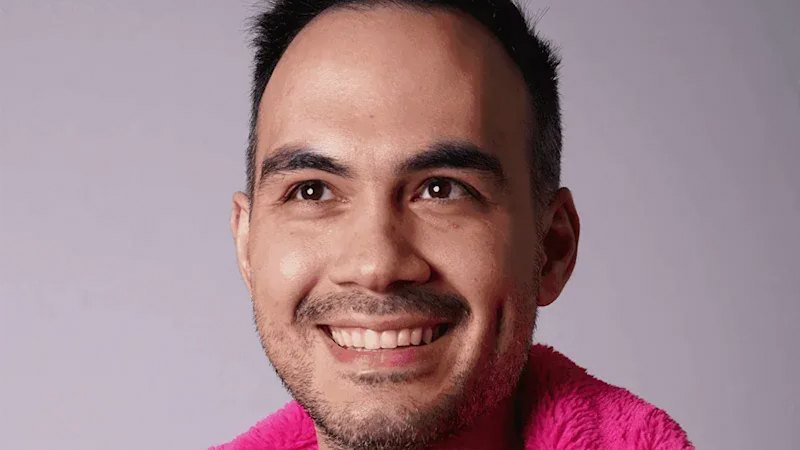
Diogo Almeida, l'un des premiers développeurs en intelligence artificielle à avoir joué un rôle central dans la création de ChatGPT, a émis une vive critique à l'encontre de cet outil emblématique, affirmant que le système a finalement échoué à tenir ses principales promesses. Selon des informations publiées le 2 octobre 2026 par le journaliste spécialisé en technologies James Titcomb, Almeida estime que l'intelligence artificielle générative grand public a pris un virage excessivement coûteux et inefficace, ce qui l'a poussé à soutenir le développement d'une alternative économique visant à bousculer le paysage actuel du marché, dominé par de lourds investissements d'entreprises.
## Les faits marquants - Diogo Almeida, reconnu comme l'un des développeurs originaux de ChatGPT, a exprimé publiquement des critiques concernant l'utilité à long terme de la plateforme. - Almeida affirme que ChatGPT n'a pas répondu aux attentes fondamentales et n'a pas concrétisé son potentiel transformateur d'origine. - Des informations publiées par le journaliste James Titcomb le 2 octobre 2026 révèlent qu'Almeida se concentre sur un concurrent économique et à bas coût face aux produits d'IA générative existants. - L'initiative cible les dépenses opérationnelles et les besoins en calcul élevés actuellement associés à l'entraînement et au fonctionnement des grands modèles linguistiques. - Cette critique reflète un débat croissant au sein de la communauté de l'apprentissage automatique sur la viabilité financière et environnementale des infrastructures massives d'intelligence artificielle.
## Ce qui s'est passé Dans un article publié le 2 octobre 2026, le journaliste James Titcomb a fait part d'une critique importante de Diogo Almeida, l'un des ingénieurs fondateurs associés au développement de ChatGPT. Almeida soutient que, malgré l'enthousiasme mondial, l'adoption massive par les entreprises et les investissements de plusieurs milliards de dollars qui ont suivi le lancement public de ChatGPT, la technologie a fondamentalement manqué son objectif en ne parvenant pas à résoudre les défis majeurs ni à offrir une utilité accessible.
Selon le récit de Titcomb, l'insatisfaction d'Almeida face à l'orientation prédominante de l'intelligence artificielle générative l'a incité à soutenir un concurrent à bas coût. Ce modèle alternatif vise à remettre en cause la dépendance dominante du secteur envers des architectures de réseaux de neurones hyper-capitalisées et gourmandes en puissance de calcul. Plutôt que de poursuivre l'augmentation du nombre de paramètres des modèles au prix d'investissements colossaux, l'approche d'Almeida privilégie une réduction drastique des coûts afin de rendre des capacités d'intelligence artificielle fonctionnelles nettement plus accessibles à un public plus large.
Bien que le premier article n'ait pas divulgué de spécifications techniques précises, de détails d'architecture propriétaire ni de structures d'entreprise formelles associées au nouveau projet d'Almeida, l'annonce souligne un virage stratégique qui s'éloigne du modèle à fortes infrastructures préconisé par les grandes entreprises de la Silicon Valley.
## Pourquoi c'est important La critique publique de ChatGPT par l'un de ses premiers créateurs met en lumière un dilemme croissant dans les secteurs de la technologie, de la finance et des logiciels d'entreprise. Ces dernières années, des entreprises technologiques mondiales, des investisseurs financiers et des institutions ont engagé des centaines de milliards de dollars dans la construction de centres de données massifs, l'acquisition de microprocesseurs de pointe et l'entraînement de modèles d'intelligence artificielle toujours plus complexes. Cette affectation massive de capitaux a été motivée par l'hypothèse selon laquelle l'augmentation de la puissance de calcul entraîne des améliorations directes et linéaires de l'intelligence, de la précision et de l'utilité opérationnelle des modèles.
Si des développeurs pionniers comme Diogo Almeida estiment que les modèles de pointe actuels ne parviennent pas à tenir leurs promesses fondamentales, la justification globale de dépenses de capital incontrôlées dans l'IA générative pourrait faire l'objet d'un examen accru de la part des conseils d'administration et des marchés financiers. Les coûts opérationnels élevés — en particulier le coût de calcul nécessaire pour chaque requête utilisateur, connu sous le nom de coût d'inférence — restent un goulet d'étranglement économique majeur empêchant de nombreuses entreprises, organisations de santé et institutions publiques de déployer l'intelligence artificielle à grande échelle. Un concurrent réellement viable et à bas coût, atteignant des performances comparables sans nécessiter des fermes de serveurs de plusieurs milliards de dollars, pourrait fondamentalement modifier la dynamique du marché, réduire les marges bénéficiaires des fournisseurs de plateformes dominants et démocratiser l'accès à des outils automatisés puissants dans les marchés en développement et les écosystèmes de petites entreprises.
## Le contexte Pour évaluer le contexte plus large de la position d'Almeida, il est utile de revenir sur l'émergence historique de ChatGPT et l'évolution structurelle ultérieure du secteur de l'intelligence artificielle générative. Développé par la société de recherche en intelligence artificielle OpenAI, basée à San Francisco, ChatGPT a été officiellement mis à la disposition du public sous la forme d'un prototype logiciel le 30 novembre 2022. Reposant sur des architectures de réseaux de neurones de type « transformer » — un concept initialement détaillé dans des travaux universitaires fondamentaux publiés par des ingénieurs de Google en 2017 —, ChatGPT a immédiatement acquis une renommée internationale pour sa capacité à générer du texte en langage naturel, à rédiger du code complexe et à synthétiser des informations multidisciplinaires.
Après sa sortie, ChatGPT a battu des records historiques d'adoption rapide par les consommateurs, atteignant environ 100 millions d'utilisateurs mensuels actifs en l'espace d'environ deux mois. Ce succès a suscité une vive concurrence à travers l'ensemble du secteur technologique mondial, incitant des entreprises rivales à construire de massifs clusters de calcul exploitant des dizaines de milliers de processeurs graphiques spécialisés, principalement fabriqués par Nvidia Corporation. Le secteur a largement adopté un paradigme connu sous le nom de lois d'échelle (« scaling laws »), affirmant que l'augmentation continue du volume des données d'entraînement et de la capacité de calcul était la condition essentielle pour parvenir à l'intelligence artificielle générale.
Malgré ces investissements astronomiques, la mise en œuvre pratique a mis en évidence des vulnérabilités persistantes au sein des grands modèles linguistiques. Celles-ci incluent des tendances structurelles à générer de fausses informations (communément appelées hallucinations), une latence élevée lors des pics d'utilisation, une consommation d'électricité massive et des coûts d'abonnement substantiels pour les utilisateurs individuels et professionnels. Ces limites ont relancé l'intérêt des ingénieurs logiciels pour des approches alternatives, telles que les petits modèles linguistiques, la compression de modèles, l'optimisation algorithmique et les architectures à poids ouverts conçues pour offrir des capacités spécialisées à une fraction du coût traditionnel.
## Les réactions Aucune déclaration publique officielle ni réponse formelle d'OpenAI, d'entreprises technologiques rivales ou de dirigeants du secteur concernant les remarques d'Almeida n'a été répertoriée dans la couverture initiale de James Titcomb. Historiquement, les principales organisations d'intelligence artificielle s'abstiennent de faire des déclarations publiques formelles sur les critiques ou les projets externes initiés par d'anciens membres de leur équipe de recherche.
Néanmoins, la position d'Almeida devrait trouver un écho au sein des institutions de recherche académique, des communautés du logiciel open source et des dirigeants technologiques d'entreprises. Les analystes du secteur et les fonds de capital-risque suivent fréquemment les mouvements et les prises de parole publiques des premiers ingénieurs fondateurs afin d'identifier les évolutions architecturales émergentes ou les goulets d'étranglement économiques dans le développement logiciel. Si Almeida ou les équipes de développement associées venaient à publier des articles techniques, des dépôts de code open source ou des démonstrations logicielles publiques, des évaluations techniques formelles et des tests de performance sont attendus sur les canaux de développeurs, les réseaux de pré-publication académique et les forums technologiques spécialisés.
## Ce que l'on ignore encore Le rapport initial laisse plusieurs détails techniques et opérationnels cruciaux sans réponse. Notamment, le nom officiel de l'initiative d'intelligence artificielle à bas coût, sa structure d'entreprise sous-jacente et l'identité d'éventuels partenaires d'investissement institutionnels n'ont pas été spécifiés publiquement dans la couverture de James Titcomb.
En outre, des paramètres techniques précis restent inconnus, notamment l'architecture du modèle sous-jacent, le nombre total de paramètres, la composition du jeu de données d'entraînement et les techniques exactes d'efficacité logicielle ou matérielle utilisées pour obtenir un fonctionnement à bas coût. Surtout, aucune donnée de référence indépendante — telle que des évaluations standardisées sur la compréhension linguistique multitâche ou les performances de codage — n'a été publiée pour étayer la comparaison entre cette alternative à bas coût et les modèles de pointe établis. Le rapport ne confirme pas non plus si la technologie sera mise à disposition sous forme de logiciel open source, de service API payant ou de plateforme spécialisée pour les entreprises.
## Les éléments à surveiller À l'avenir, des indicateurs clés permettront de déterminer si le concept à bas coût d'Almeida peut représenter un véritable défi commercial pour les plateformes d'intelligence artificielle grand public. Les acteurs du secteur devront surveiller les dépôts publics de logiciels, les archives de pré-publications de recherche et les registres d'entreprises pour déceler d'éventuelles annonces officielles de projets ou des documentations techniques publiées décrivant le fonctionnement interne du modèle.
De plus, les évènements sectoriels à venir, les conférences de développeurs open source et les évaluations comparatives constitueront des étapes cruciales. Si les premiers tests bêta ou les grilles tarifaires de l'API démontrent qu'un modèle à bas coût peut exécuter des tâches de raisonnement complexes sans la lourde infrastructure de calcul actuellement exigée par ChatGPT, les développeurs d'IA historiques pourraient être contraints d'ajuster leurs modèles de tarification et de réorienter leurs efforts d'ingénierie vers l'efficacité plutôt que vers la simple recherche de taille.
Ce rapport est basé sur la couverture médiatique originale publiée par le journaliste spécialisé en technologies James Titcomb le 2 octobre 2026.
Source : James Titcomb